O que é uma LSM tree? A estrutura de dados por trás da maioria dos bancos de dados modernos
Correções ao vídeo
O artigo abaixo está correto nestes pontos. O vídeo não.
- média A Run #2 é gravada no flush como dani, edu, fabi, mas no passo de compaction aparece como cron 115, dani, edu. O artigo usa a segunda versão do começo ao fim.
- alta O WAL é apresentado como proteção "in case the power goes out" (caso a energia caia). O WAL padrão do RocksDB só garante recuperação após a queda do processo. Sobreviver a uma queda de energia exige escritas sincronizadas.
- média "Sequential writes are 10 to 100 times faster, even on a modern SSD" (escritas sequenciais são de 10 a 100 vezes mais rápidas, mesmo em um SSD moderno) não tem fonte primária, e o paper citado ao lado (Mohan et al.) mede I/O amplification em sistemas de arquivos, não essa razão.
- baixa "Back in 1991 a team at DEC developed it" (em 1991, uma equipe da DEC desenvolveu isso): a versão de 1991 é um relatório técnico da UMass Boston, dos mesmos quatro autores. Só Edward Cheng estava na DEC.
Toda vez que você escreve em um banco de dados, seus dados passam por alguma estrutura que decide onde os bytes vão parar no disco. Em boa parte dos bancos criados nas últimas duas décadas (RocksDB, Cassandra, CockroachDB, TiKV, ScyllaDB, YugabyteDB e muitos outros) essa estrutura é uma Log-Structured Merge tree, ou LSM tree.
Este artigo percorre como uma LSM tree funciona, da primeira escrita até a compaction, com diagramas para você ficar olhando e links para ir mais fundo.
O que acontece depois do db.put()?
Você chama db.put(key, value) e a chamada retorna. Em algum ponto entre essa função e o disco físico, o banco precisa decidir onde o valor fica e como encontrá-lo de novo. A resposta a essa pergunta molda todo o resto: a velocidade das escritas, a velocidade das leituras e quanto disco você paga.
O ponto de partida: B-trees e escritas aleatórias
Por décadas a resposta padrão foi a B-tree. A B-tree mantém as chaves ordenadas em páginas de tamanho fixo, organizadas como uma árvore rasa. As leituras são excelentes: alguns saltos de página a partir da raiz e você está na folha certa. A maioria dos bancos relacionais ainda indexa dados assim, e com boa razão.
O custo aparece nas escritas. Para atualizar uma chave no lugar, o storage engine precisa achar a página folha exata que contém essa chave, modificá-la e gravar a página de volta. Escritas consecutivas de chaves sem relação caem em páginas sem relação, então cada uma é um I/O aleatório.
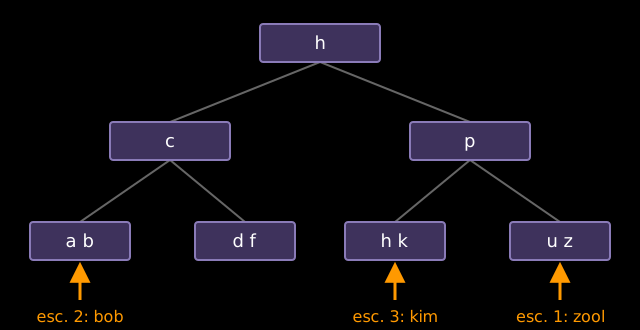
Em um disco rígido isso significa mover fisicamente a cabeça de leitura. Em um SSD não há cabeça, mas o storage engine ainda grava páginas inteiras: mudar uma linha de 128 bytes pode significar regravar uma página inteira de 4 KB (exemplo de Mark Callaghan).
O arquivo de gavetas
Imagine um arquivo com dez mil pastas em ordem alfabética. Cada vez que alguém te entrega um documento, você acha a gaveta certa, puxa a pasta, encaixa a página na ordem e devolve a pasta. Um documento é tranquilo. Cem pessoas te entregando documentos ao mesmo tempo, cada um para uma gaveta diferente, e a fila cresce mais rápido do que você consegue arquivar. Você trabalha na velocidade máxima e continua ficando para trás, porque o gargalo é a caminhada, não o arquivamento.
Essa caminhada é o I/O aleatório. Escrever um item depois do outro em linha reta, o I/O sequencial, é bem mais barato. O próprio paper da LSM tree estima isso em cerca de dez para um nos discos da época: uma página movida como parte de um grande bloco de várias páginas custava aproximadamente um décimo de um I/O aleatório de página única (O’Neil et al., seção 3.1). As B-trees deixam essa diferença na mesa.
A ideia da LSM: pare de arquivar na hora
E se você não arquivasse cada documento assim que ele chega? Em vez disso, coloque na mesa. Quando a pilha estiver alta o bastante, ordene tudo de uma vez e arquive a pilha inteira em uma única viagem.
Esse é o truque inteiro, descrito por O’Neil, Cheng, Gawlick e O’Neil no paper da LSM tree de 1996: adiar e agrupar o trabalho para que o disco só veja grandes escritas sequenciais.
MemTable: a mesa
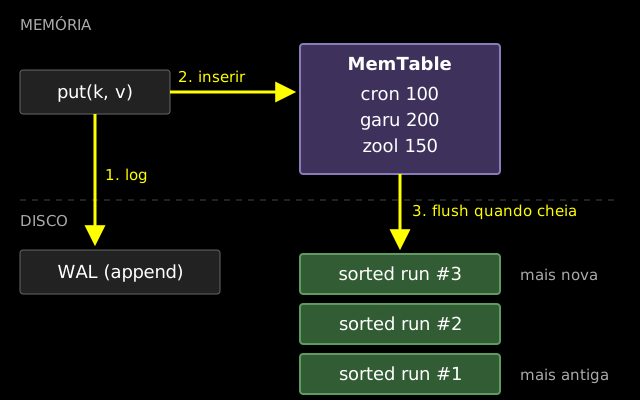
As escritas que chegam vão para uma estrutura em memória mantida ordenada por chave, chamada MemTable. No RocksDB ela é uma skip list por padrão; outros storage engines usam árvores balanceadas ou algo parecido. Não há acesso a disco aqui, então inserir é barato.
Flush: uma rajada sequencial
Quando a MemTable atinge o limite de tamanho, o storage engine a congela, abre uma nova para as escritas seguintes e grava a congelada no disco como um único arquivo ordenado e imutável. Cada storage engine chama isso de sorted run ou SSTable (Sorted String Table, nome que vem do Bigtable). Como os dados já estão ordenados, o arquivo é gravado do começo ao fim em uma passada. Essa é a escrita sequencial que queríamos.
WAL: para o caso de a energia cair
A MemTable vive na memória, então uma queda a perderia. Antes de uma escrita tocar a MemTable, o storage engine a anexa a um write-ahead log (WAL) no disco. Anexar também é sequencial. Ao reiniciar, o storage engine reproduz o log para reconstruir a MemTable. Depois do flush de uma MemTable, a parte do log que lhe corresponde pode ser apagada. Na configuração padrão, o RocksDB garante recuperação após a queda do processo; sobreviver à queda da máquina ou a um corte de energia exige que a escrita seja sincronizada no disco, o que quem chama precisa pedir explicitamente. Veja a documentação do WAL do RocksDB para os detalhes.
Então o write path é: log, buffer, flush. Nada no disco é modificado no lugar. Dados novos só são anexados.
Um exemplo passo a passo
Chegam três escritas: cron → 100, garu → 200, zool → 150. Elas entram na MemTable em ordem de chave. A MemTable enche e sofre flush para o disco como a Run #1.
Chegam mais três escritas: cron → 115 (uma atualização), dani → 300, edu → 250. Outro flush, e agora existe a Run #2 ao lado da Run #1. Repare que cron agora existe nos dois arquivos com valores diferentes. Nada foi atualizado no lugar; o valor novo simplesmente foi escrito em algum lugar mais recente.
As escritas continuam rápidas por mais runs que se acumulem. Com as leituras, a história é outra.
O problema da leitura
Para ler garu, o storage engine precisa achar o valor mais recente dessa chave. Ele confere os lugares onde o dado pode estar, do mais novo para o mais antigo:
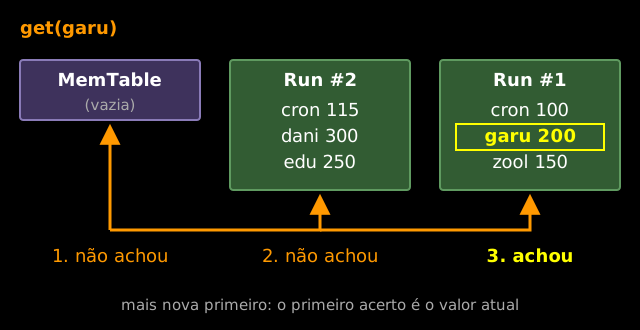
- A MemTable: talvez tenha sido escrita há pouco. Não está lá.
- Run #2, o arquivo mais novo no disco. Não está lá.
- Run #1. Achou:
garu → 200.
Cada run é ordenada, então olhar dentro de uma é uma busca binária, não uma varredura. O problema é quantas runs existem. Com duas, é rápido. Depois de flushes suficientes podem ser duzentas, e uma chave que mora na run mais antiga, ou que nem existe, significa duzentas buscas. As escritas são rápidas porque só anexamos. As leituras ficam mais lentas com o tempo porque há cada vez mais onde procurar.
Storage engines reais acrescentam truques para pular arquivos rapidamente (Bloom filters, intervalos de chaves por arquivo, caches), que merecem um aprofundamento próprio. Mas eles reduzem o custo por arquivo; não eliminam o número crescente de arquivos. Alguma coisa precisa fazer a limpeza.
Compaction: o faxineiro de background
Compaction é um job em background que pega duas ou mais sorted runs e as funde em uma só por merge sort. Como cada entrada já está ordenada, é um merge em streaming, o mesmo passo da segunda metade do merge sort, e é sequencial tanto na leitura quanto na escrita.
Quando a mesma chave aparece em mais de uma entrada, a versão mais nova vence e a mais antiga é descartada. Deletes funcionam do mesmo jeito: um delete é gravado como um marcador especial (um tombstone), e a compaction acaba descartando tanto o marcador quanto os valores que ele encobre (as notas de implementação do LevelDB descrevem exatamente isso).
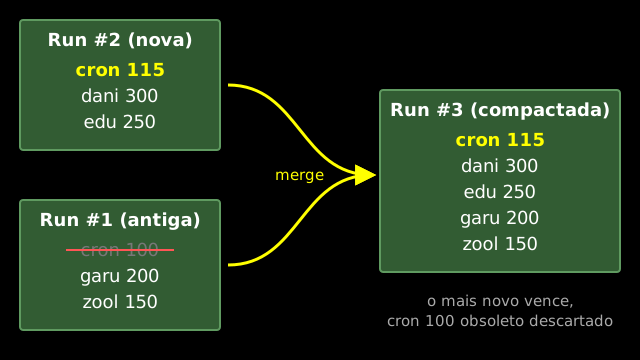
cron → 100 obsoleto desaparece.Depois da compaction, uma leitura de garu consulta um arquivo em vez de dois, e o disco não guarda mais o cron → 100 morto. Esse é o ciclo completo da LSM: buffer, flush, compaction.
O que a compaction custa
Compactar não é de graça. Para produzir a Run #3, o storage engine leu as duas entradas do disco e gravou de novo cada byte que sobreviveu. Um valor que você escreveu uma vez pode ser reescrito várias vezes ao longo da vida, conforme é fundido em runs cada vez maiores. O RocksDB Tuning Guide chama isso de write amplification: você escreve 10 MB/s no banco, vê 30 MB/s chegarem ao disco, e seu write amplification é 3. Para um banco de 500 GB com leveled compaction, o mesmo guia calcula cerca de 33, e boa parte do guia trata de manter esse número sob controle.
Esse é o tradeoff: leituras mais rápidas, pagas com trabalho extra de escrita em background.
O triângulo de amplification
Todo storage engine LSM equilibra três custos ao mesmo tempo:
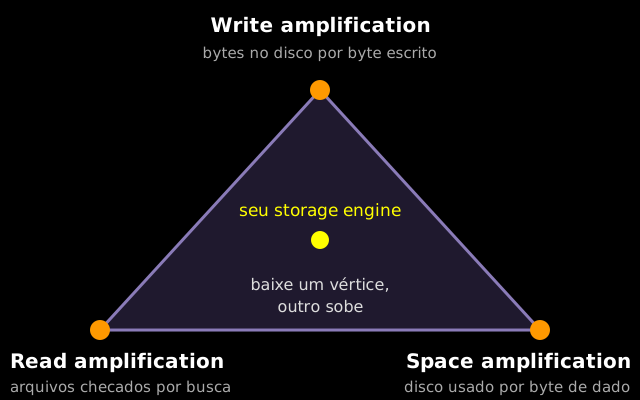
- Write amplification: bytes gravados no disco por byte que a aplicação escreveu. Faça compaction de forma mais agressiva e ele sobe.
- Read amplification: quantos lugares uma busca precisa checar. Deixe as runs se acumularem antes de fazer a compaction e ele sobe.
- Space amplification: disco usado por byte de dado vivo. Versões obsoletas esperando a compaction, mais cópias temporárias enquanto uma compaction roda, empurram esse valor para cima. Uma compaction que reescreve tudo mantém entrada e saída no disco ao mesmo tempo, então um dataset de 1 GB pode precisar brevemente de 2 GB (ScyllaDB).
Você não consegue minimizar os três ao mesmo tempo. Baixe um vértice e pelo menos um dos outros sobe. Isso não é um problema de qualidade de código; é uma restrição estrutural. O post Read, write & space amplification: B-Tree vs LSM, de Mark Callaghan, é o tratamento curto mais claro, e Athanassoulis et al. o formalizaram como a RUM Conjecture em 2016. Esse tradeoff guia o projeto de todo storage engine LSM.
De onde veio e para onde foi
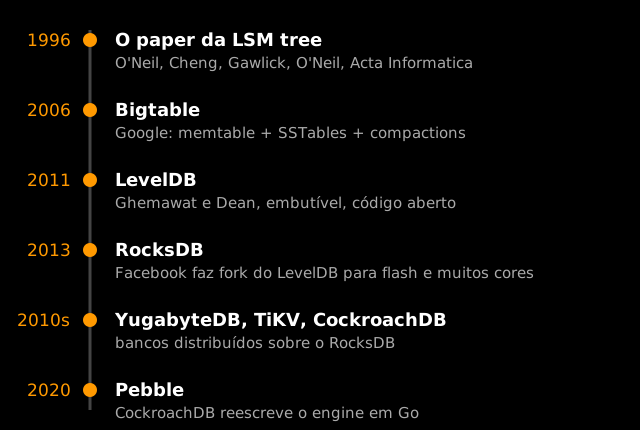
Os quatro autores descreveram a ideia pela primeira vez em um relatório técnico da UMass Boston de 1991, que o paper de 1996 na Acta Informatica cita; o coautor Edward Cheng estava na Digital Equipment Corporation. O Bigtable do Google (2006) levou o design de MemTable mais SSTables mais compaction para produção em larga escala. Sanjay Ghemawat e Jeff Dean então escreveram o LevelDB, aberto em 2011, um storage engine pequeno e embutido com o mesmo design (as notas de implementação são curtas e valem a leitura).
O Facebook construiu o RocksDB sobre o LevelDB e o abriu em 2013, porque o LevelDB não acompanhava o flash storage rápido e servidores com muitos cores (sua compaction single-thread causava write stalls). O RocksDB virou o storage engine embutido padrão de uma geração de bancos distribuídos: o TiKV é construído sobre ele, engenheiros que ajudaram a criá-lo foram co-fundar o YugabyteDB sobre um RocksDB modificado, e o CockroachDB rodou nele desde o início até reescrever o storage engine em Go como Pebble (o padrão desde a versão 20.2, em 2020), em parte porque não conseguiam fazer profiling através da fronteira entre Go e C++.
Mesma estrutura, apostas diferentes
Todos esses storage engines partem dos mesmos três passos. Acabam em lugares bem diferentes do triângulo porque seus workloads são diferentes: alguns apostam em leituras rápidas, outros em escritas baratas, outros em latência previsível, outros em usar menos disco. A superfície de tuning é grande o bastante para que a própria equipe do RocksDB escreva, nas notas finais do tuning guide:
Even we as RocksDB developers don’t fully understand the effect of each configuration change.
(tradução: Nem mesmo nós, desenvolvedores do RocksDB, entendemos totalmente o efeito de cada mudança de configuração.)
Se a estrutura é a mesma, por que existem tantos storage engines? Esse é o assunto de por que existem tantos storage engines LSM, que pega o tradeoff de três vias acima e mostra como cada storage engine escolhe seu vértice.
Fontes e leitura complementar
Fontes
- O’Neil, Cheng, Gawlick, O’Neil, The Log-Structured Merge-Tree (LSM-Tree), Acta Informatica, 1996
- ByteByteGo, The Secret Sauce Behind NoSQL: LSM Tree
- Facebook Engineering, Under the Hood: Building and open-sourcing RocksDB, 2013
- Cockroach Labs, Introducing Pebble: A RocksDB-inspired key-value store written in Go
- TiKV, RocksDB in TiKV
- ScyllaDB, Scaling ScyllaDB storage engine with state-of-art compaction
- Andy Pavlo, CMU Intro to Database Systems, #04 Database Storage: Log-Structured Merge Trees & Tuples, Fall 2024
- Mohan, Kadekodi, Chidambaram, Analyzing IO Amplification in Linux File Systems
- Google, LevelDB
- RocksDB Wiki, Write Ahead Log (WAL)
- RocksDB Wiki, Tuning Guide
- Athanassoulis et al., Designing Access Methods: The RUM Conjecture, EDBT 2016
- Unite.AI, Karthik Ranganathan, Co-Founder and Co-CEO of Yugabyte, Interview Series
Leitura complementar
- Chang et al., Bigtable: A Distributed Storage System for Structured Data, OSDI 2006
- LevelDB, Implementation notes
- RocksDB Wiki, MemTable
- Mark Callaghan, Read, write & space amplification: B-Tree vs LSM, 2015
- Dong et al., RocksDB: Evolution of Development Priorities in a Key-value Store Serving Large-scale Applications, ACM TOS 2021
- Cockroach Labs, Adventures in Performance Debugging, 2016
- YugabyteDB, DocDB performance enhancements to RocksDB
- ScyllaDB, Compaction Series: Space Amplification
- Martin Kleppmann, Designing Data-Intensive Applications, chapter 3