Por que existem tantos storage engines? A RUM Conjecture explicada
Correções ao vídeo
O artigo abaixo está correto nestes pontos. O vídeo não.
- alta A probabilidade do Bloom filter está invertida. O vídeo diz que o filtro erra cerca de 1% das vezes, então "provavelmente sim" costuma significar sim. O 1% vale para chaves que não estão na run: cerca de 1 em cada 100 delas ainda recebe "provavelmente sim".
- média A RUM é chamada de "a prova" e se diz "a matemática diz que não dá". É uma conjectura, não um teorema provado.
- alta A compaction tiered é descrita como "sem cascata". As runs ainda passam por merge no nível seguinte. O que o tiering evita é reescrever as runs que já estão lá.
- média "O Cassandra 5.0 passou para uma estratégia unificada": a UCS é recomendada no 5.0, mas o padrão continua sendo a size-tiered (STCS).
- baixa "Antes disso, as estratégias não tinham uma linguagem em comum" exagera. Os nomes leveled e size-tiered já existiam, e o Cassandra já trazia as duas.
LevelDB, RocksDB, Pebble, Cassandra, ScyllaDB, TigerBeetle, TiKV, YugabyteDB: dezenas de storage engines são construídos sobre a mesma ideia, a LSM tree. Se a estrutura é a mesma, por que ninguém construiu o melhor storage engine de todos e encerrou o assunto?
Porque cada engine dessa lista paga uma conta diferente. A ideia comum, em resumo: uma LSM tree guarda as escritas em memória, faz flush de sorted runs para o disco e faz compaction delas em segundo plano. Escritas são rápidas, leituras podem ser lentas, e a compaction tem custo. Esses custos se trocam entre si; este artigo dá a essa troca o nome que ela tem na pesquisa e mostra quem escolheu qual lado dela.
A RUM Conjecture: escolha dois
Imagine um triângulo de write, read e space amplification: você não consegue reduzir os três ao mesmo tempo. Essa afirmação tem nome. Athanassoulis, Kester, Maas, Stoica, Idreos, Ailamaki e Callaghan a chamam de RUM Conjecture: os três custos são Read (leitura), Update (atualização) e Memory (memória). Nas palavras do artigo:
designing access methods that set an upper bound for two of the RUM overheads, leads to a hard lower bound for the third overhead which cannot be further reduced.
(tradução: projetar métodos de acesso que fixam um limite superior para dois dos custos RUM leva a um limite inferior rígido para o terceiro custo, que não pode ser reduzido mais.)
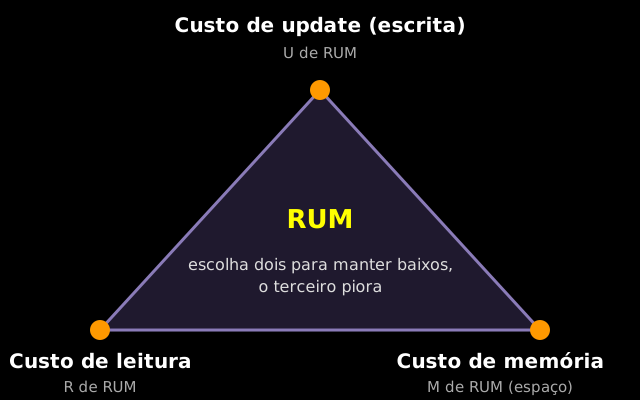
Dois detalhes importam. Primeiro, é uma conjectura, não um teorema provado: o artigo a defende a partir dos limites inferiores de métodos de acesso feitos sob medida para cada custo isolado, e é o tipo de restrição em que você esbarra na prática, meio como o CAP para armazenamento (essa comparação é uma analogia, não algo que o artigo afirma). Segundo, você não dá a volta nela. Você escolhe qual penalidade aceitar. A Figura 1 do próprio artigo posiciona estruturas populares nesse espaço: índices hash, B-trees, tries e skiplists do lado otimizado para leitura, LSM trees e outras estruturas diferenciais do lado otimizado para escrita, e Bloom filters, bitmaps e índices esparsos do lado otimizado para espaço. Mark Callaghan, cujo post Read, write & space amplification: B-Tree vs LSM é o tratamento prático mais claro do tema, é coautor, listado com o Facebook.
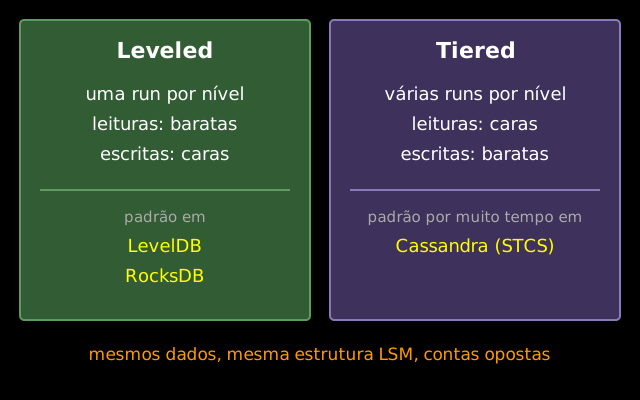
Para uma LSM tree a pergunta fica concreta: com que agressividade você faz compaction? Muita compaction deixa as leituras baratas e as escritas caras. Pouca compaction deixa as escritas baratas e as leituras pagam a conta. Duas estratégias ficam nas pontas desse espectro, e ambas são descritas lado a lado no artigo do Dostoevsky: leveling e tiering.
Compaction leveled: prateleiras organizadas
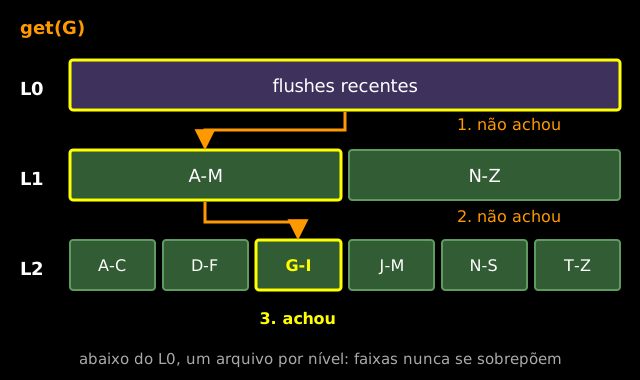
Na compaction leveled, todo nível, exceto o nível 0, guarda uma única sorted run, dividida em arquivos cujas faixas de chaves não se sobrepõem. As notas de implementação do LevelDB dizem isso diretamente: os arquivos do nível jovem (nível 0) podem conter chaves sobrepostas, mas os arquivos dos demais níveis têm faixas de chaves distintas, sem sobreposição. O Dostoevsky resume a política em uma linha: com leveling, “we merge runs within a level whenever a new run comes in” (tradução: fazemos merge das runs dentro de um nível sempre que chega uma nova run).
Essa estrutura torna as leituras previsíveis. Para achar a chave G, você consulta o nível 0 e depois, no máximo, um arquivo em cada nível mais fundo, porque só um arquivo pode ser dono daquela faixa de chaves.
A cascata de escrita
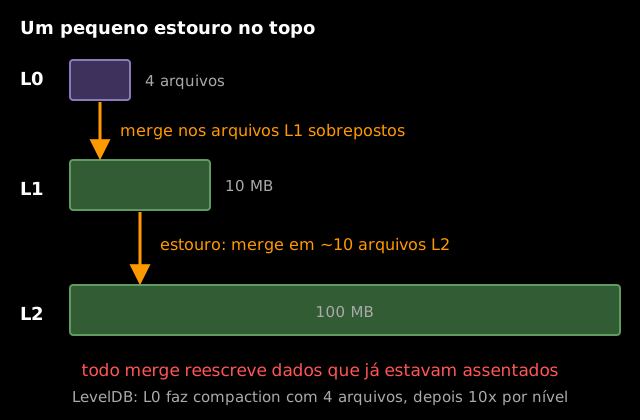
O preço está do lado da escrita. Quando o nível 0 enche, seus arquivos entram no nível 1 por merge e, para manter o nível 1 limpo e sem sobreposição, esse merge inclui os dados que já estão lá. No RocksDB, os arquivos L0 normalmente se sobrepõem, então todos são escolhidos, e depois pelo menos um arquivo L1 faz merge “with the overlapping range” (tradução: com a faixa sobreposta) do L2 quando o L1 ultrapassa seu alvo. Cada nível é cerca de dez vezes maior que o de cima (notas do LevelDB: 10 MB para o nível 1, 100 MB para o nível 2, e assim por diante).
Os engenheiros do ScyllaDB mostram a aritmética: um arquivo L1 cobre cerca de um décimo do espaço de chaves, um arquivo L2 um centésimo, então fazer compaction de um único arquivo L1 significa fazer merge dele com cerca de dez arquivos L2 sobrepostos. Um pequeno estouro no topo vira uma grande reescrita lá embaixo.
Uma coisa que a cascata não é: uma questão de segurança dos dados. O write-ahead log já tornou os dados duráveis. A compaction existe para deixar as leituras rápidas.
Quão ruim é o write amplification? Depende da razão de tamanho entre níveis, do número de níveis e da carga de trabalho. No experimento que o ScyllaDB descreve, a estratégia leveled escreveu 111 GB para o conjunto de dados que eles estavam carregando, “13-fold write amplification, and over twice the write amplification of STCS” (tradução: write amplification de 13 vezes, e mais que o dobro do write amplification da STCS), e eles observam que escritas individuais podem ter um write amplification de 50 vezes. Então o quadro é: você escreve 1 GB de dados seus, e o disco pode movimentar dez, vinte ou mais vezes isso ao longo da vida. Callaghan acrescenta que leveled costuma ser pior que tiered nesse ponto, mas é competitiva em alguns casos, como inserções em ordem de chave e escritas concentradas em poucas chaves (skewed).
Leituras baratas, escritas caras. Esse é o estilo de compaction padrão do RocksDB, e o LevelDB também o usa. Se sua carga é pesada em leitura (um app voltado ao usuário, uma camada de serving), leveled é a aposta natural.
Compaction tiered: a mesa bagunçada
A compaction tiered inverte a regra. Várias sorted runs podem coexistir em cada nível, e suas faixas de chaves podem se sobrepor. Segundo o Dostoevsky: “with tiering, we merge runs within a level only when the level reaches capacity.” (tradução: com tiering, fazemos merge das runs dentro de um nível só quando o nível atinge a capacidade.) Quando um nível enche, é feito o merge de todas as suas runs em uma só run, que desce.
As escritas ficam baratas. Os dados novos caem ao lado dos que já estão lá. Quando um nível enche, suas runs passam por merge e descem como uma nova run, sem reescrever as runs que já esperam no nível seguinte. Um dado do mesmo experimento do ScyllaDB acima: o write amplification da leveled foi mais que o dobro do da size-tiered. Os docs do próprio RocksDB dizem o mesmo em termos gerais: a tiered “provides far better write amplification with worse read amplification” (tradução: oferece um write amplification bem melhor com um read amplification pior). (O RocksDB chama seu estilo tiered de compaction universal; Callaghan observa que todos os outros LSMs a chamam de tiered.)
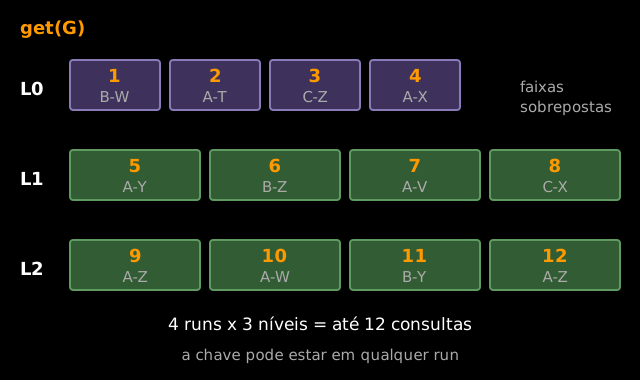
A conta chega nas leituras. Uma chave pode estar em qualquer run, então uma busca pode ter de consultar todas as runs de todos os níveis.
Há também um custo de espaço. Durante um merge, as runs antigas e a nova run resultante existem ao mesmo tempo; a documentação do Cassandra avisa que o disco necessário para as SSTables antigas e novas durante a compaction size-tiered pode ultrapassar o espaço que um nó tem. O ScyllaDB mediu um space amplification de quase 8 vezes para a size-tiered em seu próprio experimento de sobrescrita. A regra prática de “o dobro dos dados durante um merge” é a versão branda disso.
A estratégia size-tiered do Cassandra está documentada como o padrão se você não especificar nada e como recomendada para workloads pesados em escrita (a mesma página hoje recomenda a Unified Compaction Strategy para a maioria dos workloads a partir do Cassandra 5.0, que mistura as duas abordagens). Por anos, se você ingeria logs, telemetria ou dados de sensores e as leituras eram raras ou toleravam latência, tiered era a resposta.
Bloom filters: o mais perto de um almoço grátis
As duas estratégias pagam por leituras que tocam arquivos que não contêm a chave. Dá para deixar as leituras mais rápidas sem deixar as escritas mais lentas? Dá, em parte: um Bloom filter anexado a cada sorted run.
Pense em um segurança com uma lista de convidados. Se o filtro diz “não está na lista”, a chave definitivamente não está naquela run, e essa resposta está sempre certa. O Dostoevsky descreve exatamente assim: um Bloom filter não retorna falso negativo, mas pode retornar falso positivo. Quando ele diz “talvez”, você ainda precisa ler a run, porque a resposta pode estar errada: para uma chave que não está na run, o filtro ainda diz “talvez” uma vez em cada cem.
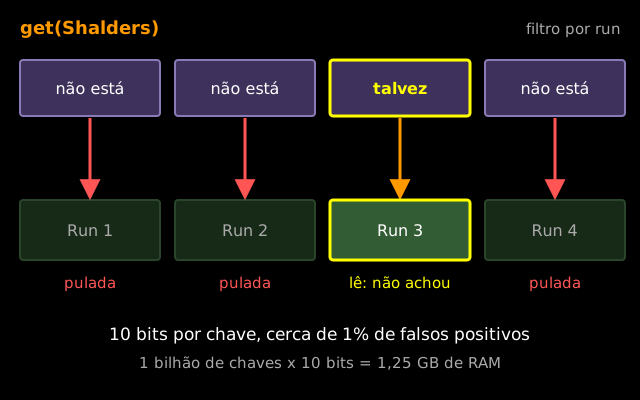
O custo é memória. O Dostoevsky observa que key-value stores na indústria usam 10 bits por entrada, o que dá uma taxa de falsos positivos de cerca de 1%, e o wiki de Bloom filter do RocksDB concorda: sua configuração de exemplo usa cerca de 10 bits por chave, que “works well for many workloads” (tradução: funciona bem para muitas cargas), e 9,9 bits por chave dão uma taxa de falsos positivos de 1%. Faça a conta para um bilhão de chaves: 10^9 chaves vezes 10 bits são 10^10 bits, ou seja, 1,25 GB de RAM. Arredonde para 1,2 GB: o suficiente para evitar quase todas as leituras de disco desperdiçadas em centenas de gigabytes de dados.
Não é de graça. Mais chaves significam mais memória de filtro, e em algum ponto o orçamento de RAM acaba. A RUM Conjecture continua valendo: sempre há uma conta em algum lugar. Aqui ela é paga em Memória.
O tour pelos sistemas: mesma estrutura, apostas diferentes
Com as duas estratégias e o filtro em mãos, os engines deixam de parecer duplicatas.
O LevelDB é o projeto original. Seus autores são Sanjay Ghemawat e Jeff Dean, ele tem sete níveis (kNumLevels = 7) e usa compaction leveled. A Cockroach Labs descreve o tamanho original do LevelDB como 30 mil linhas de código. O Facebook descobriu que sua compaction single-threaded não funcionava bem para certos workloads de servidor. Veja como uma LSM tree funciona para a história.
O RocksDB é o que o Facebook construiu em cima dele. Ele se baseia no LevelDB para escalar em servidores many-core e usar armazenamento rápido com eficiência, e cresceu das 30 mil linhas originais do LevelDB para mais de 350 mil linhas. Está embutido em muitos outros bancos: o TiKV o usa, os fundadores do YugabyteDB ajudaram a construí-lo e rodam uma versão modificada, e o CockroachDB o usou até o Pebble. O preço de todo esse poder é uma superfície de configuração tão grande que o guia oficial de tuning admite:
Even we as RocksDB developers don’t fully understand the effect of each configuration change.
(tradução: Nem nós, desenvolvedores do RocksDB, entendemos totalmente o efeito de cada mudança de configuração.)
Essa frase é do RocksDB Tuning Guide, em “Final thoughts”.
O Pebble é a resposta da Cockroach Labs. Eles o escreveram em Go, focado no que o CockroachDB precisa, com pouco mais de 45 mil linhas de código, e o anunciaram como substituto do RocksDB como storage engine padrão na versão 20.2. O README dele lista as funcionalidades do RocksDB que ele não implementa: column families, universal compaction, FIFO compaction, sub-compactions, transações e mais. Um engine de uso geral pode perder para um enxuto, reduzido ao que um único banco exige. (A história completa da reescrita: Why CockroachDB Replaced RocksDB with Pebble.)
O Cassandra e o ScyllaDB levam o design de LSM tree para muitas máquinas. O Instagram se descreveu como operando uma das maiores instalações de Cassandra do mundo em uma palestra no F8 de 2018. O ScyllaDB é um banco distribuído escrito em C++ com compatibilidade de API com o Cassandra. O benchmark da Samsung, publicado pelo ScyllaDB, relata throughput de 10x a 37x melhor que o do Cassandra no mesmo conjunto de 2 TB ao longo de duas horas. É um benchmark publicado por um fornecedor, em hardware de ponta (o mesmo post diz que a diferença é de 1,5x a 3x em máquinas menores), então trate a faixa como um dado e não como uma promessa.
O TigerBeetle vai pelo outro caminho: faz uma coisa só. Ele guarda apenas contas e transferências, e um registro de conta tem só 128 bytes. A análise do Jepsen em 2025 das versões 0.16.11 a 0.16.30 encontrou sete quedas de cliente e servidor e apenas dois problemas de safety, e concluiu que a partir da 0.16.30 o TigerBeetle parecia cumprir sua promessa de Strong Serializability (o relatório foi financiado pelo TigerBeetle). Joran Greef descreve a extensão do storage engine LSM do TigerBeetle com um conector para object storage nos níveis mais baixos, mantendo os dados quentes perto da CPU e os frios baratos.
Quem deu nome a tudo isso
Os termos básicos já estavam em uso: o Cassandra trazia as estratégias size-tiered e leveled, e o Dostoevsky compara tiering e leveling. O que faltava era um acordo sobre o que exatamente eles significavam. Em Name that compaction algorithm, Callaghan estabeleceu leveled, tiered, tiered+leveled, leveled-N e time-series (os dois híbridos eram nomes novos), e defendeu que “LSM tree” deveria ser ampliado para incluir mais do que a compaction leveled. Ele também diz não ter certeza de que esses nomes já foram definidos formalmente, então os nomes são um vocabulário, não um padrão.
O que todos esses engines assumem
Todo sistema acima compartilha uma suposição tão básica que nenhum deles a questiona: os dados vivem em um disco local. SSD ou HD, ele está fisicamente ligado à máquina que roda o banco.
E se essa suposição quebrar? E se o disco fosse quase infinito e barato, mas cada leitura custasse dinheiro de verdade? É assim que o object storage se parece, e ele muda qual canto do triângulo dói: as velhas trocas são reprecificadas, e um design ajustado para discos locais precisa ser repensado. S3 e object storage para bancos de dados mostra como isso fica.
Fontes e leitura complementar
Fontes
- Engines LSM em produção (LevelDB, RocksDB, Pebble, Cassandra, ScyllaDB, TigerBeetle, TiKV, YugabyteDB), citados individualmente abaixo
- Athanassoulis et al., Designing Access Methods: The RUM Conjecture, EDBT 2016
- Mark Callaghan, Read, write & space amplification: B-Tree vs LSM, 2015
- Dayan, Idreos, Dostoevsky: Better Space-Time Trade-Offs for LSM-Tree Based Key-Value Stores, SIGMOD 2018
- Mark Callaghan, Universal Compaction in RocksDB and Me, 2023
- Cockroach Labs, Introducing Pebble, 2020
- TiKV, RocksDB in TiKV
- Unite.AI, Interview with Karthik Ranganathan, co-founder of YugabyteDB
- Dostoevsky, Seção 2 (tiered compaction), mesmo artigo da fonte 4
- Apache Cassandra docs, Size Tiered Compaction Strategy
- Dostoevsky, Seção 2 (Bloom filters), mesmo artigo da fonte 4
- Conta: 1 bilhão de chaves x 10 bits por chave = 1,25 GB
- Google, LevelDB
- Facebook Engineering, Under the Hood: Building and open-sourcing RocksDB, 2013
- RocksDB Wiki, Tuning Guide
- Cockroach Labs, anúncio do Pebble, mesmo post da fonte 6
- Pebble README, funcionalidades do RocksDB não implementadas
- Instagram, Cassandra on RocksDB at Instagram, F8 2018
- ScyllaDB, Technology
- TigerBeetle docs, Account
- Joran Greef, A Trillion Transactions, TigerBeetle, 2026: a palestra e a versão escrita
- Mark Callaghan, Name that compaction algorithm, 2018
- ScyllaDB, Compaction Series: Write Amplification in Leveled Compaction, 2018
- RocksDB Wiki, RocksDB Bloom Filter
Leitura complementar
- LevelDB, Implementation notes
- RocksDB Wiki, Leveled Compaction and Universal Compaction
- Apache Cassandra docs, Unified Compaction Strategy
- ScyllaDB, Scylla vs Cassandra performance benchmark by Samsung
- Jepsen, TigerBeetle 0.16.11
- YugabyteDB, DocDB performance enhancements to RocksDB