CockroachDB: por que jogaram o RocksDB fora
Correções ao vídeo
O artigo abaixo está correto nestes pontos. O vídeo não.
- média O limite do Compactor não é "dez por cento do disco". Ele dispara com mais de 256 MiB ou 10% dos bytes lógicos em uso (ou 10% do espaço ainda disponível).
- média As range tombstones foram "ligadas mais tarde naquele ano" (2022) apenas na branch de desenvolvimento. A versão 22.2 saiu com a opção desligada. Elas ficam sempre ligadas a partir da v23.1.
- baixa "A equipe chamou de administrável" se refere ao custo de copiar valores, mas o post de 2019 chama de administráveis os contornos do cgo.
- média A conta de um milhão de chaves usa 200 ns por chamada, o número de 2016. Com os 52 ns mostrados logo antes, um milhão de chamadas custa cerca de 0,05 s, não 0,2 s.
Fevereiro de 2016. Um engenheiro do CockroachDB roda um benchmark que insere linhas aleatórias. No primeiro segundo ele escreve cerca de 1.944 linhas por segundo. Um minuto depois, está em 105. Ele abre o profiler do Go para achar o loop lento, e o profiler mostra quase nada: a maior parte do tempo é gasta dentro do RocksDB, do outro lado de uma fronteira que o profiler do Go não atravessa.
A história mais contada é que o CockroachDB reescreveu o RocksDB em Go porque Go é mais agradável. Os dois motivos reais já estão nesse bug. Numa LSM tree, um delete é uma escrita, e os dados só saem do disco durante a compaction. E toda chamada de Go para C++ paga um pedágio. Quatro anos depois, o CockroachDB lançou o próprio storage engine, o Pebble.
Um pouco de contexto ajuda. Uma LSM tree guarda as escritas em memória, faz flush delas para o disco como arquivos ordenados chamados sorted runs, e faz o merge dos sorted runs em segundo plano (a compaction). O RocksDB é o fork do LevelDB feito pelo Facebook, um storage engine LSM escrito em C++ que muitos bancos embutem (seu design). O CockroachDB o usava como storage engine.
Um delete é uma escrita
Arquivos LSM nunca são editados no lugar. Uma atualização é uma entrada nova, e a entrada mais recente de uma chave vence. Então um delete também não consegue remover nada. Ele escreve uma entrada nova dizendo que a chave sumiu, chamada de tombstone. Como o engenheiro que achou o bug colocou: “When you delete a key you add a record (a deletion tombstone) that shadows the existence of the old key.” (tradução: Quando você apaga uma chave, você adiciona um registro (uma tombstone de deleção) que esconde a existência da chave antiga.)
Uma leitura que encontra a tombstone primeiro para ali e trata todo valor mais antigo como apagado. O valor antigo continua no disco, por baixo.
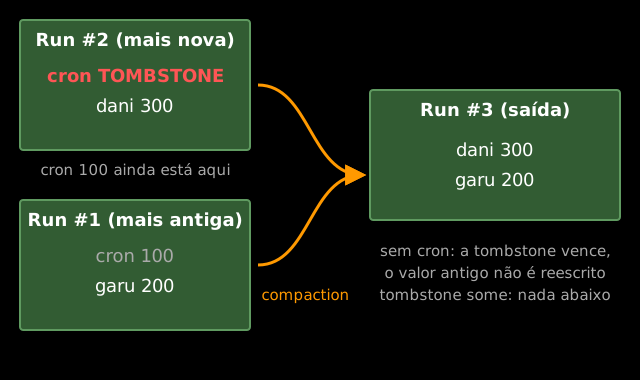
cron 100 até a compaction juntar os dois arquivos.O valor antigo só sai quando a compaction faz o merge dos dois sorted runs: a tombstone vence, e o valor antigo não é escrito de novo. A própria tombstone só pode ir embora quando não sobra nada mais antigo abaixo dela para esconder. No compaction iterator do Pebble dá para ver as duas regras: uma chave coberta por uma range deletion é ignorada, e deletes pontuais só são descartados quando o storage engine consegue provar que não há nada mais antigo embaixo.
Uma caixa de pizza vazia na geladeira serve de modelo mental. Quem olha encontra a caixa primeiro e sabe que não sobrou nada, mas a caixa continua ocupando a prateleira. Ela sai no dia do lixo, e numa LSM tree o dia do lixo é a compaction.
Até lá, uma tombstone custa espaço, e custa leitura. Um scan precisa atravessar cada tombstone no caminho, porque não tem como saber que uma chave está morta sem olhar a entrada mais recente dela. Esse é o loop do começo.
Toda escrita é uma versão
O CockroachDB adiciona mais uma camada por cima. Ele nunca sobrescreve uma chave. Toda escrita é uma versão nova marcada com um timestamp, o que é MVCC (controle de concorrência multiversão). O timestamp é guardado logo depois da chave, e o comparer o inverte, então as versões ficam ordenadas da mais nova para a mais antiga. O post de 2016 diz o mesmo: “the keys are sorted by descending timestamp.” (tradução: as chaves são ordenadas por timestamp decrescente.)
Uma leitura no tempo 4 faz seek para key@4, e a primeira versão em que ela cai é a resposta. Um delete é só mais uma versão, escrita com valor vazio.
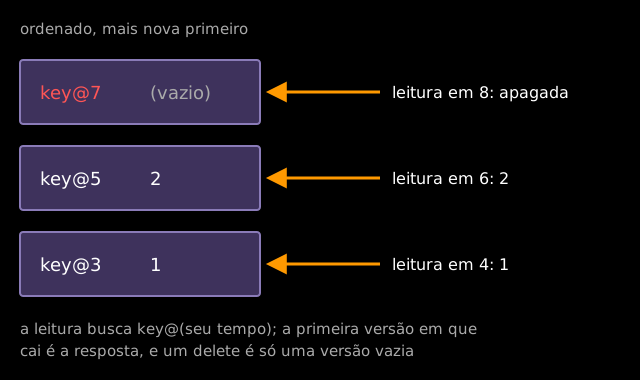
key@7 e pega key@5.As versões antigas ficam no disco para que leituras no passado continuem funcionando. Elas saem por garbage collection, depois de quatro horas por padrão nas versões atuais (eram 25 horas até a v23.1 reduzir para clusters novos).
O bug de 2016, passo a passo
Agora o benchmark. O relato de Peter Mattis leva a um padrão simples. Toda transação de escrita também escreve um registro de transação e o apaga quando faz commit. Inserções aleatórias deixavam um trecho crescente de registros apagados lado a lado na MemTable.
Cada transação nova começava checando se o seu registro existia. Esse seek caía no trecho de tombstones, e o seek em si levava microssegundos. A parte lenta era o que vinha depois: o iterator passava pelos registros apagados um a um, procurando a próxima chave viva, “upwards of 20,000 times” (tradução: mais de 20.000 vezes) até o desempenho degradar visivelmente.
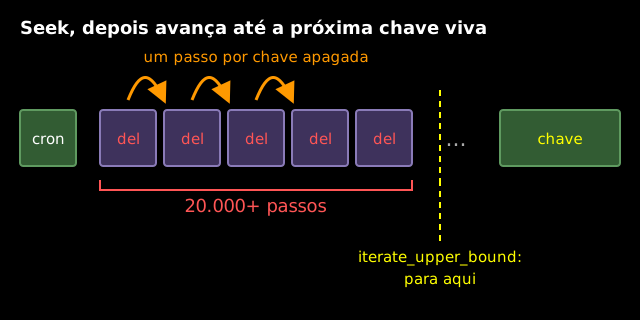
A correção foi uma opção que o RocksDB já tinha: iterate_upper_bound. Com um limite, o scan para no fim do intervalo que importa, em vez de seguir até a próxima chave viva. O mesmo benchmark, depois disso, começou em 3.028 linhas por segundo e ainda estava em 2.579 após um minuto.
É como achar o armário de lanches vazio. Sem limite, você continua andando, pela cozinha e até a casa do vizinho, até achar comida em algum lugar. Com limite, o armário era a busca inteira.
Esse bug veio de apagar uma chave por vez. O problema maior era apagar milhões de uma vez.
Apagando um intervalo inteiro
Apagar uma tabela com cem milhões de linhas exigiria cem milhões de tombstones pontuais. A RFC de range keys do Pebble chama a versão MVCC disso de “prohibitively expensive” (tradução: proibitivamente cara). Por isso as LSM trees têm um segundo tipo de delete: a range tombstone, uma entrada que cobre toda chave de um início até um fim. (O RocksDB também tem isso, como DeleteRange. Não é uma invenção do Pebble.)
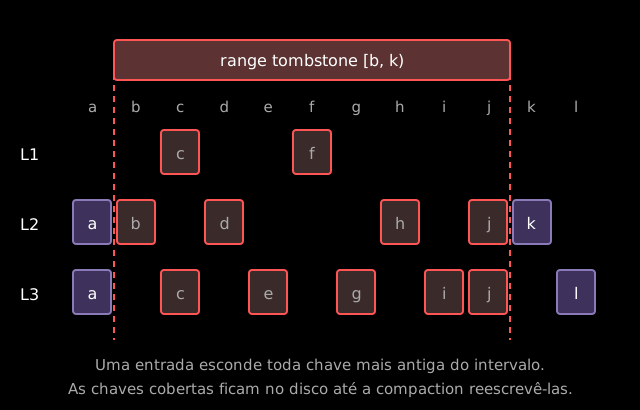
Uma leitura que cai dentro do intervalo vê o marcador e já sabe a resposta. Um scan também não passa pelas chaves cobertas: o merging iterator do Pebble faz seek nos níveis inferiores direto para o fim do intervalo.
Mas o espaço não volta sozinho. Os dados cobertos continuam no disco em todos os níveis abaixo do marcador, e só a compaction pode descartá-los, quando reescreve os arquivos que o marcador cobre.
Um picker que não olhava
Foi aqui que o CockroachDB se machucou. O anúncio do Pebble diz sem rodeios: a necessidade do Compactor “stems from RocksDB not taking range deletion operations into consideration in its compaction decisions.” (tradução: vem de o RocksDB não levar operações de range deletion em conta nas suas decisões de compaction.)
Então, em dezembro de 2017, Spencer Kimball adicionou um compactor ao CockroachDB. Depois de cada range delete, ele registrava uma compaction sugerida. Quando as sugestões de um intervalo podiam liberar mais de 256 MiB, ou 10% dos bytes lógicos em uso (ou 10% do espaço ainda disponível), ele pedia ao RocksDB que fizesse compaction daquele intervalo.
Pense no que isso significa. Um banco de dados agendava, por fora, as compactions do próprio storage engine. A lógica de que precisava morava no código de outra pessoa, do outro lado da mesma fronteira que o profiler não atravessava.
O RocksDB já corrigiu essa parte: a partir da versão 7.10 (lançada em janeiro de 2023), o tamanho de um arquivo para a escolha de compaction inclui os bytes que suas range tombstones apagam. A reclamação de 2020 era verdadeira na época. Não é verdadeira para o RocksDB de hoje.
O pedágio do cgo
Os deletes eram um custo da fronteira entre linguagens. As leituras pagavam o outro, em toda consulta.
Uma leitura MVCC é um loop. Para cada chave, ela passa pelas versões mais novas que seu timestamp e pega a primeira que pode ver, de olho nos write intents de transações que ainda não fizeram commit. No CockroachDB, esse loop rodava em Go, e cada passo era uma chamada separada ao RocksDB.
O CockroachDB é escrito em Go e o RocksDB em C++. O Go chega ao código C por uma ponte chamada cgo, e a ponte cobra um pedágio a cada travessia. Em 2015 a equipe mediu: 171 ns para uma chamada vazia via cgo contra 1,83 ns para uma chamada Go comum, “approximately a factor of 100” (tradução: aproximadamente um fator de 100). O mesmo post faz questão de acrescentar que, em tempo absoluto, 171 ns costuma ser um preço perfeitamente aceitável.
O cgo também ficou mais barato desde então. Rodei o mesmo formato de benchmark (Go 1.25.5, Ryzen 7 3700X) e obtive cerca de 52 ns contra 1,8 ns, algo como 29 vezes em vez de 100. Hardware diferente, então compare as razões, não os nanossegundos brutos.
Uma travessia não é nada. Um scan que chama o RocksDB uma vez por chave paga em toda chave. Aos ~200 ns por chamada com que a equipe trabalhava em 2016 (um número ilustrativo), um milhão de chaves é um quinto de segundo gasto só atravessando. Com os 52 ns de hoje, seria cerca de um vigésimo.
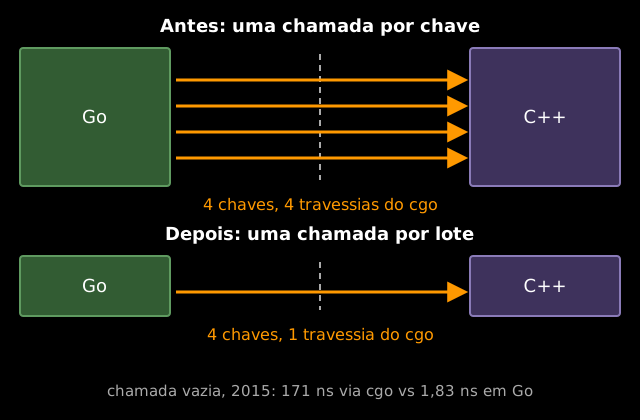
Então, em 2018, Peter Mattis moveu o loop de scan inteiro para o C++: uma travessia por lote de chaves. A mensagem do commit relata um COUNT(*) sobre 5 milhões de linhas caindo de 4,3 s para 2,3 s. Comprar pão do outro lado da rua funciona igual. Atravessar a rua a cada pãozinho custa mais em caminhada do que em pão, então você compra dez e atravessa uma vez.
O pedágio agora era pago em código. O anúncio do Pebble diz que a equipe escreveu “significant amounts of logic in C++ in order to avoid the performance overhead of frequent crossings from Go to C++, at times duplicating logic that already existed in Go.” (tradução: quantidades significativas de lógica em C++ para evitar o overhead de desempenho de travessias frequentes de Go para C++, às vezes duplicando lógica que já existia em Go.)
O profiler ainda parava na ponte, e os valores lidos do RocksDB eram copiados da memória C para a memória Go. Em janeiro de 2019, a equipe chamou de “manageable so far” (tradução: administrável até agora) o trabalho de contornar o overhead do cgo, “keeping an eye on when this calculation changes.” (tradução: de olho em quando essa conta mudar.)
Havia também um custo humano. Do mesmo anúncio:
While the absolute number of bugs we’ve encountered in RocksDB is modest, their severity is often high, and the urgency to fix them is frequently House Is On Fire.
(tradução: Embora o número absoluto de bugs que encontramos no RocksDB seja modesto, a severidade costuma ser alta, e a urgência para corrigi-los é frequentemente House Is On Fire, a casa está pegando fogo.)
e, sobre as mais de 350 mil linhas de C++ por trás deles: “doable (we’ve done it), yet hardly what could be described as a good time.” (tradução: factível (já fizemos), mas dificilmente algo que se descreveria como um bom momento.) O post acrescenta que “the barrier between Go and C++ is psychologically real.” (tradução: a barreira entre Go e C++ é psicologicamente real.)
Começando do zero: o Pebble
O primeiro commit do Pebble, de Peter Mattis em junho de 2018, se chama “Initial fork (leveldb -> pebble)”. Ele partiu do port do LevelDB para Go, não do RocksDB, e tomou emprestado o design do RocksDB onde o CockroachDB precisava.
Um desvio rápido: Mattis e Spencer Kimball, dois dos fundadores do CockroachDB, também anunciaram juntos a primeira versão do GIMP em 1995, como estudantes de Berkeley.
Só o que o CockroachDB precisa
O README diz que o Pebble intencionalmente não aspira a incluir todas as funcionalidades do RocksDB, e lista as que ficam de fora: catorze, incluindo column families, universal compaction, transações e FIFO compaction. Column families (keyspaces separados, com configurações próprias, dentro de um mesmo banco) e universal compaction (uma estratégia de compaction alternativa) são funcionalidades do RocksDB. Nenhuma entrou.
O tamanho conta a mesma história. Em 2020 o anúncio contava um pouco mais de 45 mil linhas de código e outras 45 mil de testes. Contando eu mesmo as linhas Go fora de testes em um commit de 2026, dá cerca de 174 mil (a mesma contagem dá cerca de 52 mil no fim de 2020). Um storage engine que é seu também continua crescendo. Ter um engine próprio é como ter uma casa em vez de alugar: nada quebra no cronograma de outra pessoa, mas todo conserto e todo cômodo novo é você que constrói.
Deletes viraram cidadãos de primeira classe
O primeiro ganho foi para os deletes, e é o oposto do Compactor.
- Delete-only compactions. Em 2020 o Pebble as adicionou: um arquivo inteiramente sob uma range tombstone é removido da lista de arquivos, “simply constructing a manifest edit that drops the files without reading them” (tradução: simplesmente construindo uma edição do manifest que descarta os arquivos sem lê-los).
- Tamanhos de arquivo ponderados por tombstones. O picker infla o tamanho de um arquivo pelo espaço que seus deletes deveriam liberar (compensated size). Arquivos cheios de deletes parecem maiores, então entram em compaction mais cedo.
- Chega de Compactor. Em junho de 2020 a equipe o desligou para o Pebble, porque a escolha de compaction do Pebble “is aware of range deletions and will prioritize reclamation of disk space.” (tradução: conhece as range deletions e vai priorizar a recuperação de espaço em disco.)
O loop de scan que tinha ido para o C++ voltou como Go: um comentário nele o chama de port em Go do scanner em C++. Agora um único profiler enxerga o caminho todo, da consulta até o disco.
Opcional, depois padrão
O Pebble saiu como opção no CockroachDB v20.1 (maio de 2020) e virou o padrão na v20.2, em novembro, segundo o README. O RocksDB foi removido do código em outubro de 2020, então a versão seguinte, a v21.1, em maio de 2021, saiu só com Pebble. Contando em versões, os dois engines conviveram por cerca de um ano, não dois. Nas seis cargas YCSB padrão, a equipe relatou que o Pebble “meets or exceeds” (tradução: iguala ou supera) o RocksDB.
Apagando dados sem perder o histórico
Ter o engine também significava que ele podia aprender coisas de que só o CockroachDB precisava.
Uma range delete simples remove os dados e o histórico junto. Um backup, ou uma leitura no passado, não consegue ver o que havia ali nem quando sumiu. O jeito MVCC, uma versão vazia por chave, preserva o histórico mas custa uma escrita para cada chave da tabela.
Então o Pebble adicionou range keys: uma entrada que cobre um intervalo de chaves e carrega um timestamp (RFC). No CockroachDB, ela significa “tudo neste intervalo foi apagado no tempo 6”.
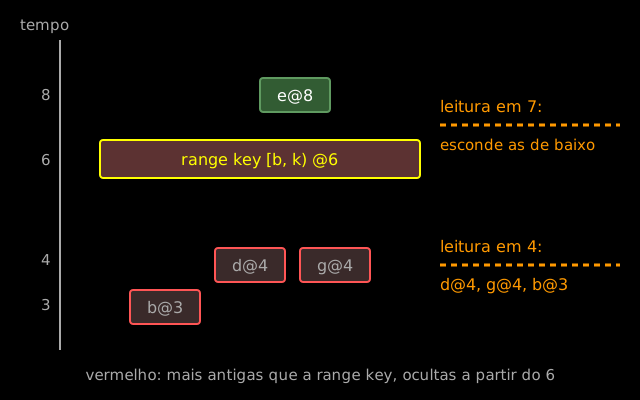
Uma leitura depois do tempo 6 vê a range key e esconde tudo que é mais antigo embaixo dela. Uma leitura antes do tempo 6 vê os dados como eram, então backups e histórico continuam funcionando. Cada bloco de dados também registra a faixa de timestamps que contém, então uma leitura com masking pode pular um bloco inteiro quando toda versão nele é mais antiga que a range key (a opção de masking é o que habilita isso).
A nota técnica do CockroachDB resume: o mesmo efeito de tombstones pontuais em todas as chaves, “with a constant rather than linear write/storage cost” (tradução: com custo de escrita/armazenamento constante em vez de linear). Ela chegou na versão 22.2, desligada por padrão ali, foi ligada por padrão na branch de desenvolvimento em novembro de 2022 e está sempre ligada a partir da v23.1.
Quem usa o Pebble hoje, e quando não usar
Escolha o Pebble quando seu programa é escrito em Go e embute o próprio armazenamento. É por isso que o go-ethereum o usa como padrão. Não é só o cliente principal do Ethereum:
- O Arbitrum Nitro cria bancos novos no Pebble por padrão.
- O Bor, da Polygon, o usa como padrão.
- O CometBFT, o consensus engine por baixo do Cosmos, mudou seu banco padrão para o Pebble na v1.0.
- O serviço rainbow firehose do Bluesky guarda sua janela de backfill no Pebble, e o store do Jetstream também o usa.
- O TiDB Lightning, da PingCAP, ordena importações em massa no Pebble antes de ingerir no TiKV, que por sua vez roda sobre RocksDB.
Quase todos são programas Go que embutem o próprio armazenamento.
Fique com o RocksDB quando precisar do que o Pebble deixou de fora, como column families, universal compaction ou transações, ou quando seu programa não for escrito em Go.
O que o Pebble resume
Guardar na MemTable, fazer flush dos sorted runs para o disco, fazer compaction em segundo plano. Esse último passo é onde os deletes finalmente acontecem, então o storage engine que o executa precisa saber o que um delete significa. A resposta do CockroachDB foi uma branch própria, nascida do port do LevelDB para Go, com o tratamento de tombstones e a fronteira de linguagem de que precisava e pouco mais.
Fontes e leitura complementar
Fontes
- Cockroach Labs, Adventures in performance debugging, Peter Mattis, March 2016, and issue #4196, February 2016
- Cockroach Labs, The cost and complexity of Cgo, December 2015
- Peter Mattis, Reimplement MVCC{Scan,Get} in C++ (PR #21395), January 2018
- Cockroach Labs, Introducing Pebble: A RocksDB-inspired key-value store written in Go, September 2020
- Cockroach Labs, Why we built CockroachDB on top of RocksDB, January 2019
- Spencer Kimball, Compactor PR #20607, December 2017
- PR #50508, compactor disabled for Pebble, June 2020
- Jackson Owens, Pebble PR #784, delete-only compactions, July 2020
- Pebble, compaction_picker.go, compensated file sizes
- Pebble, README, non-goals and release timeline
- Pebble, first commit, June 2018
- GIMP, Prehistory, and Cockroach Labs, About
- Cockroach Labs, PR #55509, Remove RocksDB, October 2020
- Sumeer Bhola and Jackson Owens, Pebble range keys RFC, October 2021
- Erik Grinaker, MVCC range tombstones tech note, July 2022
- Cockroach Labs, Replication controls: gc.ttlseconds
- RocksDB, PR #10734, include range tombstone bytes in compensated file size, merged December 2022
- Fonte de cada usuário do Pebble: go-ethereum, Arbitrum Nitro, Polygon Bor, CometBFT, Bluesky rainbow e Jetstream, TiDB Lightning (links inline acima)
Leitura complementar
- CockroachDB, issue #6739, the ~200 ns cgo call figure (2016)
- RocksDB Wiki, DeleteRange
- Pebble, merging iterator and compaction iterator
- CockroachDB, MVCC key encoding and MVCCDelete
- Pebble, block property filters and range key masking
- Anterior: How RocksDB became the SQLite of storage engines, e o básico em What is an LSM tree?