RocksDB: o SQLite dos storage engines

Fontes (34)Correções (3)Assista no YouTube ↗
Conteúdo
- Da biblioteca do Google ao fork do Facebook
- O que é um write stall
- Por que o nível zero é contado
- Os três medidores
- Por que o Facebook fez um fork
- Write amplification que você consegue calcular
- Dívida de compaction
- Por que tem tantos knobs
- Column families: várias LSM trees, um WAL
- Dando preço ao estilo de compaction
- O espaço virou o alvo
- Três gerações de filtros
- O piso
- Ribbon: cada chave é uma equação
- Pago em CPU, então escolha pelo tempo de vida
- O SQLite dos storage engines
- Quando escolher, e como olhar por dentro
- O que o RocksDB realmente é
- Fontes e leitura complementar
Correções ao vídeo
O artigo abaixo está correto nestes pontos. O vídeo não.
- média “escritas aleatórias dez vezes mais rápidas e leituras aleatórias 30% mais rápidas, em quase um petabyte de dados dentro do Facebook”“Ten times faster random writes and thirty percent faster random reads, on close to a petabyte of data inside Facebook” liga o benchmark ao petabyte. No post de 2013, o petabyte é o uso total do RocksDB nas aplicações do Facebook, não o conjunto de dados do benchmark.
- média “o time do RocksDB mediu de dez a trinta em produção”“The RocksDB team measured ten to thirty in production”, e de quatro a dez para tiered: o paper diz que a compaction leveled “costuma apresentar”“usually exhibits” 10 a 30 e que a tiered reduz “para a faixa de 4 a 10”“down to the 4 to 10 range”. Os valores não são apresentados como medições em produção.
- baixa Na tela, o commit de throttling de escritas aparece como parte da história do “commit feito de uma máquina do Facebook”“committed from a Facebook machine”. Esse commit veio de um endereço pessoal. O commit com o hostname do Facebook é outro (cc6c325).
Role até o commit mais antigo com código no repositório do RocksDB. Ele é de março de 2011, diz Initial checkin., e não é do Facebook. É o LevelDB, uma biblioteca de storage do Google.
Muita gente acha o RocksDB complexo demais e trata seus stalls, knobs e estilos de compaction como folclore. Este artigo constrói cada um a partir do mecanismo, e cada um acaba sendo a etiqueta de preço de um dos três custos de uma LSM tree: escrita, leitura ou espaço.
Da biblioteca do Google ao fork do Facebook
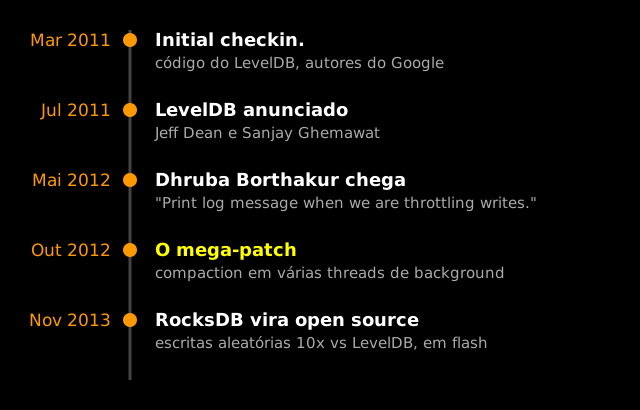
O LevelDB foi anunciado em julho de 2011 por Jeff Dean e Sanjay Ghemawat. Um precursor dele armazenava cada tablet do Bigtable, e o Chrome construiu o IndexedDB em cima dele. É uma biblioteca que você linka no seu programa, não um servidor que você roda. Também era pequeno de propósito, cerca de 30 mil linhas de código, e toda a compaction rodava em uma única thread de background.
Em maio de 2012 aparece um nome novo: Dhruba Borthakur, commitando de uma máquina do Facebook. Três semanas depois, um dos commits dele diz Print log message when we are throttling writes. Em outubro de 2012 ele integrou uma mudança bem maior, e o título do commit não faz por menos: “este é o mega-patch de compaction multi-thread”“This is the mega-patch multi-threaded compaction”. O corpo diz que ele “permite que a compaction ocorra em várias threads de background ao mesmo tempo.”“allows compaction to occur in multiple background threads concurrently.”
O que é um write stall
Todo flush adiciona um arquivo ao nível zero, e só a compaction remove arquivos. Quando os arquivos se acumulam mais rápido do que a compaction consegue fazer merge deles, o storage engine reduz as escritas de entrada de propósito, “à velocidade que o banco consegue tratar”“to the speed that the database can handle”, porque senão o space e o read amplification continuam crescendo. Deixe acumular o bastante e as escritas param por completo.
Por que o nível zero é contado
Abaixo do nível zero, cada nível é dividido em arquivos cujas faixas de chaves não se sobrepõem. O nível zero é diferente: cada arquivo gerado por um flush cobre as chaves que a MemTable tinha, que para chaves aleatórias é quase a faixa inteira. Então, segundo o Tuning Guide, “point lookups precisam consultar todos os arquivos do nível 0 e no máximo um arquivo de cada um dos outros níveis.”“Point lookups must consult all files in level 0 and at most one file from each other levels.” Bloom filters deixam isso barato para point lookups, mas não para range scans, em que “o read amplification é number_of_level0_files + number_of_non_empty_levels”“the read amplification is number_of_level0_files + number_of_non_empty_levels”.
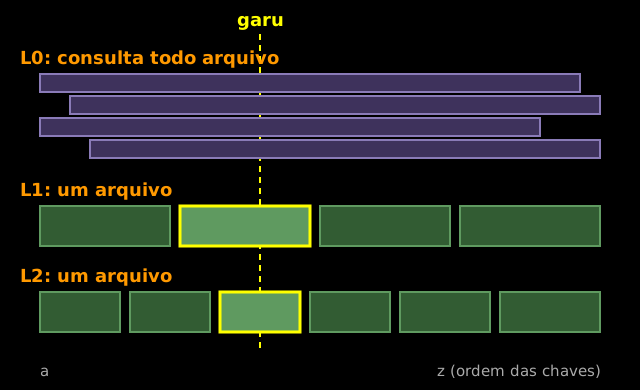
Ou seja, a contagem de arquivos do nível zero é, na prática, um teto para o custo de leitura.
Os três medidores
O RocksDB observa três coisas, em GetWriteStallConditionAndCause:
- Memtables esperando flush. As escritas param quando o número delas chega a
max_write_buffer_number(padrão 2). - Arquivos do nível zero. Gatilhos de desaceleração e de parada, comparados abaixo.
- Bytes esperando compaction. Um limite brando desacelera as escritas e um limite rígido as para, 64 GB e 256 GB por padrão.
Todos esses padrões estão em advanced_options.h. Para o nível zero, a linha mudou de um engine para o outro. O LevelDB desacelera as escritas em 8 arquivos e as para em 12. O RocksDB usa 20 e 36 por padrão.
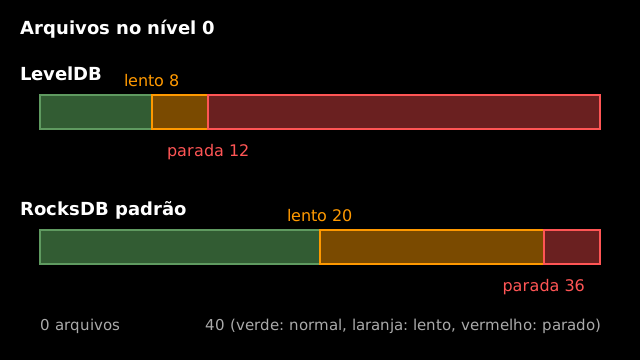
Engenheiros chamam isso de write stall. As médias o escondem, porque a maioria das escritas continua rápida; ele aparece no 1% mais lento. As próprias medições do Facebook com o LevelDB encontraram “write stalls frequentes no LevelDB que causavam latência significativa no percentil 99”“frequent write-stalls with LevelDB that caused significant 99-percentile latency”.
Por que o Facebook fez um fork
O Facebook tinha os stalls e hardware novo. A história do RocksDB, escrita por Borthakur, diz que o conjunto de dados “migrou de discos giratórios para flash”“migrated from spinning disks to flash”, onde uma leitura ou escrita cai de cerca de 10 milissegundos para cerca de 100 microssegundos. Nessa velocidade, a ida pela rede até um servidor de banco de dados deixa de ser de graça: “o acesso a dados pela rede tem 50% mais overhead que o acesso local”“Network data access is 50% higher overhead than local data access”. Então o engine precisava ser embutido.
O LevelDB já era embutido, mas “o processo de compaction single-thread do LevelDB era insuficiente para sustentar workloads de servidor.”“Leveldb’s single-threaded compaction process was insufficient to drive server workloads.” Então: “o melhor caminho era fazer um fork do código do LevelDB e mudar sua arquitetura para atender a essas necessidades. E assim o RocksDB nasceu!”“The best path was to fork the leveldb code and change its architecture to suit these needs. So, RocksDB was born!” O paper do FAST ’21 do time data isso em 2012.
O mega-patch foi o coração dessa mudança: mais threads de compaction, para que o nível zero pudesse esvaziar mais rápido. Em novembro de 2013 o Facebook abriu o código do RocksDB. Em flash, reportou escritas aleatórias “10 vezes mais rápidas”“10 times faster” e leituras aleatórias “30% mais rápidas”“30% faster” que o LevelDB, com quase um petabyte de dados já no RocksDB dentro do Facebook.
Write amplification que você consegue calcular
Mais threads só ajudam enquanto o disco tem folga, porque a compaction reescreve cada byte, mais de uma vez. Esse múltiplo é o write amplification, e o Tuning Guide faz a conta para o estilo leveled padrão.
Acompanhe um byte. Ele é escrito uma vez quando a MemTable faz flush para o nível zero (o guia deixa de fora o write-ahead log). O nível um tem o mesmo tamanho do nível zero, então fazer merge nele custa 2. Cada nível abaixo é dez vezes maior, então empurrar um arquivo para baixo reescreve cerca de dez vezes o tamanho dele em arquivos sobrepostos. O exemplo de 500 GB do guia vai de L1 a L4, então isso acontece três vezes.
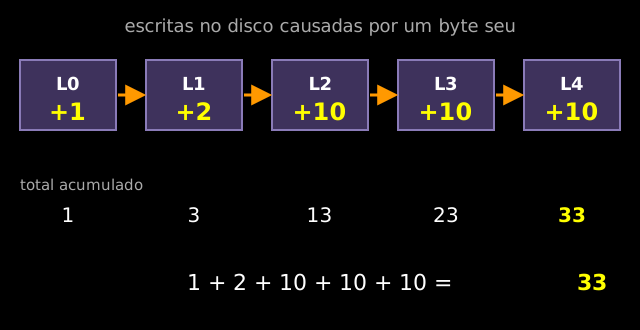
As palavras do guia: “o write amplification total é, portanto, aproximadamente 1 + 2 + 10 + 10 + 10 = 33”“Total write amplification is therefore approximately 1 + 2 + 10 + 10 + 10 = 33”. O paper do FAST diz que o RocksDB leveled “costuma apresentar write amplification entre 10 e 30”“usually exhibits write amplification between 10 and 30”, o que ele chama de “alta demais para aplicações com muita escrita”“too high for write-heavy applications”.
Dívida de compaction
Veja o que o 33 faz com um disco (nossa ilustração): 30 MB/s de escritas do usuário viram cerca de 1 GB/s de escritas de compaction, mais quase o mesmo tanto em leitura. Além do que o disco sustenta, o trabalho não terminado se acumula como dívida até algum medidor disparar. Como mensagens que você deve resposta: a pilha cresce até alguém ligar perguntando o que houve. A dívida de compaction é a pilha, e o stall é a ligação.
Por que tem tantos knobs
A velocidade veio com um preço: muitas opções. O paper diz que foi deliberado: “introduzimos muitos knobs novos e suporte a componentes plugáveis, tudo para permitir que as aplicações realizem seu potencial de desempenho”“we introduced many new knobs, and introduced the support of pluggable components, all to allow applications to realize their performance potential”, e isso “provou ser uma estratégia bem-sucedida para ganhar tração inicial.”“proved to be a successful strategy for gaining initial traction early on.”
O código cresceu junto. Em 2020 a Cockroach Labs contou mais de 350 mil linhas de RocksDB, contra as 30 mil originais do LevelDB. As opções também cresceram, pela nossa contagem de data members nas structs públicas de opções: 13 no LevelDB, 44 no RocksDB no fim de 2012, 161 no fim de 2020, 212 em setembro de 2026. Todo banco persiste suas configurações em um arquivo de opções, e o arquivo de exemplo do repositório tem 141 linhas.
O Tuning Guide é franco sobre o resultado:
Infelizmente, configurar o RocksDB de forma ótima não é trivial. Nem nós, como desenvolvedores do RocksDB, entendemos totalmente o efeito de cada mudança de configuração.
Unfortunately, configuring RocksDB optimally is not trivial. Even we as RocksDB developers don’t fully understand the effect of each configuration change.
O paper nomeia o problema real: a melhor configuração depende “também da workload gerado pelas aplicações acima dele”“also on the workload generated by the applications above them”. Em 39 deployments do ZippyDB, encontrou “mais de 25 configurações distintas”“over 25 distinct configurations”. E dentro do banco de outra pessoa, “o terceiro normalmente sabe muito pouco sobre o RocksDB e a melhor forma de ajustá-lo.”“The third party will typically know very little about RocksDB and how it is best tuned.”
Column families: várias LSM trees, um WAL
A maioria dos knobs é definida por column family. Um banco RocksDB pode conter várias LSM trees, cada uma com sua própria MemTable, arquivos e opções. Elas compartilham um único write-ahead log, então uma escrita que atravessa famílias é atômica.
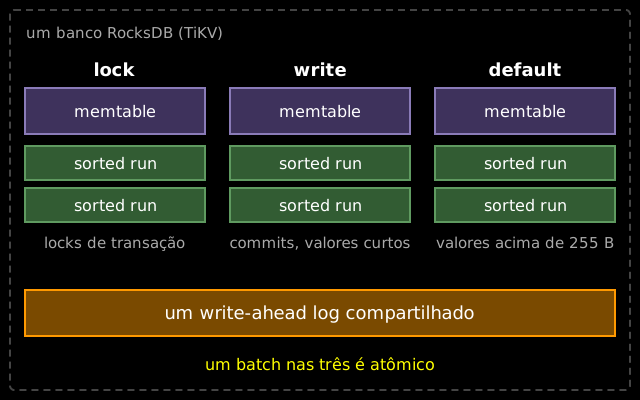
No TiKV, a visão geral do RocksDB lista uma família lock para locks de transação, uma write para dados escritos e metadados de commit, e uma default para “dados maiores que 255 bytes”“data longer than 255 bytes”, e o código do TiKV configura cada uma em sua própria seção. (Ele também mantém uma família raft, deixada de fora da figura.)
Dando preço ao estilo de compaction
O maior knob é o estilo de compaction. O RocksDB usa leveled por padrão, o 33 de cima. A universal compaction, nome do RocksDB para tiered, inverte a troca: deixa sorted runs de tamanho parecido se acumularem e faz merge deles de uma vez, então um byte só é reescrito quando seu run entra em um merge. O paper diz que tiered “reduz o write amplification para a faixa de 4 a 10, embora com desempenho de leitura menor”“brings write amplification down to the 4-10 range, although with lower read performance”. (A conjectura RUM explica a taxonomia dos estilos; aqui só colocamos preço.)
A leitura paga porque um lookup no estilo universal pode checar todo sorted run, não um arquivo por nível. O espaço também paga: durante um merge completo no estilo universal, “tanto os arquivos de entrada quanto o de saída precisam ser mantidos, então o banco temporariamente usa o dobro de espaço em disco.”“both of input files and the output file need to be kept, so the DB will be temporarily double the disk space usage.”
O espaço virou o alvo
O time descobriu depois que “para a maioria das aplicações, a utilização de espaço era muito mais importante que o write amplification”“for most applications, space utilization was far more important than write amplification”. A compaction leveled tem um problema discreto com space amplification (bytes em disco sobre dados vivos). Uma atualização não sobrescreve a cópia antiga: a versão nova cai em um nível superior enquanto a antiga espera no último nível até a compaction chegar lá. Assim, o último nível guarda quase todos os dados vivos, e tudo acima dele é overhead. A compaction leveled clássica define metas de tamanho a partir do topo: 1 GB para o nível um, depois 10, 100 e 1.000 GB. Agora guarde só 200 GB. O último nível fica com um quinto cheio, mas os níveis acima continuam dimensionados para um terabyte. O post sobre níveis dinâmicos faz essa aritmética: (200 + 100 + 10 + 1) / 200 = 1,555, um overhead de 55%.
O dimensionamento dinâmico de níveis inverte a direção. A meta do último nível é o tamanho real dele, e cada nível acima recebe um décimo do de baixo: 200 GB, depois 20, 2 e 200 MB. O mesmo post chega a 1,111.
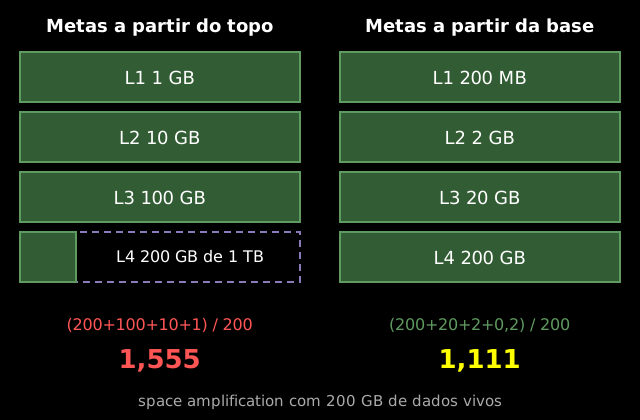
Agora cerca de 90% dos dados ficam no último nível, então os níveis acima somam só cerca de 11%, e as metas crescem junto com os dados, sem reajuste. No benchmark do time, “a dynamic leveled compaction limita o overhead de espaço a 13%, enquanto a leveled pode adicionar mais de 25%”“Dynamic Leveled Compaction limits space overhead to 13%, while Leveled Compaction can add more than 25%”, com pior caso “de até 90%”“as high as 90%”. Está ligado por padrão no código atual. Os 11% são a aritmética, os 13% a medição.
O espaço também é o motivo de o Facebook ter colocado o RocksDB sob o MySQL como MyRocks: “50 por cento menos armazenamento para a mesma quantidade de dados em comparação com InnoDB comprimido”“50 percent less storage for the same amount of data compared with compressed InnoDB”.
Três gerações de filtros
A compaction decide quanto é escrito. Os filtros decidem quanto é lido. Um Bloom filter é o segurança na porta de cada sorted run, uma pequena estrutura em memória que diz “definitivamente não está aqui” para a leitura pular o arquivo, e o RocksDB reconstruiu esse segurança três vezes, segundo o wiki de Bloom filter.
- Um filtro por bloco. A primeira geração veio do LevelDB: um filtro pequeno a cada 2 KB de dados. O problema: mesmo quando o filtro diz não, “o índice já foi carregado e consultado.”“the index is already loaded and looked into.”
- Um filtro por arquivo. “o novo formato, full filter, resolve esses problemas criando um filtro para o arquivo SST inteiro.”“The new format, full filter, addresses these issues by creating one filter for the entire SST file.” A checagem agora acontece antes de qualquer consulta ao índice, o que o paper lista entre as primeiras economias de CPU.
- Ribbon. Disponível desde a versão 6.15.0 como substituto direto.
O piso
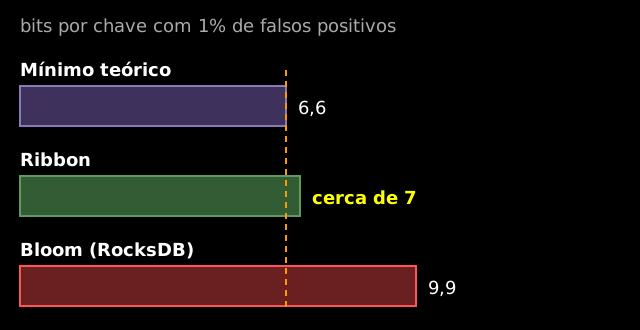
Um Bloom filter liga alguns bits por chave, e um único zero no lookup significa que a chave nunca foi adicionada. Um filtro com 1% de falsos positivos precisa de no mínimo log2(100), cerca de 6,6 bits por chave (Carter et al., STOC 1978). Um Bloom filter padrão precisa de 1,44 vez isso, cerca de 9,6 bits. O Bloom filter cache-local do RocksDB precisa de um pouco mais: o wiki dá 9,9 bits por chave a 1%.
Ribbon: cada chave é uma equação
O Ribbon, de Peter Dillinger e Stefan Walzer, também faz hash de cada chave para posições, mas não as liga. Essas posições precisam combinar, por XOR, em um fingerprint curto da chave. Então cada chave vira uma equação, e construir o filtro resolve todas as equações de uma vez e guarda só a solução. No código do RocksDB isso é um sistema linear sobre GF(2) resolvido com eliminação gaussiana on-the-fly.
No Bloom, as chaves só adicionam uns, então, para manter os acertos por acaso raros, cerca de metade dos bits precisa ficar em zero. No Ribbon, o solver escolhe cada bit, então todos fazem trabalho útil. Um lookup recalcula sua única equação, e uma chave que nunca foi adicionada só confere por acaso. O wiki diz que uma política Ribbon ajustada para os mesmos 1% “usa apenas cerca de 7 bits por chave”“only uses around 7 bits per key”, perto do piso. O paper diz que o Ribbon pode levar o overhead sobre esse piso para menos de 10%, “com algum tempo de CPU adicional”“with some additional CPU time”.
O anúncio da Meta diz que filtros Ribbon “economizam cerca de 1/3 da memória em comparação com Bloom filters”“save roughly 1/3 of memory compared with Bloom filters”, o que ela espera que some vários por cento de RAM na escala do Facebook.
Pago em CPU, então escolha pelo tempo de vida
O preço é a resolução. O wiki diz que o Ribbon usa “cerca de 3 a 4 vezes mais CPU em filtros”“about 3-4x as much CPU on filters”, e que “a maior parte do tempo de CPU adicional está nos jobs de background que constroem os filtros.”“most of the additional CPU time is in the background jobs constructing the filters.” Então a política Ribbon mistura os dois: por padrão (filter_policy.h), ela constrói Bloom filters para arquivos recém-gerados por flush, que a compaction logo substitui, e Ribbon para os níveis mais longevos abaixo. Um filtro construído uma vez e lido por muito tempo compensa a CPU extra.
O SQLite dos storage engines
Qual é o banco de dados mais implantado do mundo? Não é Oracle, nem Postgres. O SQLite se diz o database engine mais amplamente implantado, presente em todo dispositivo Android, todo iPhone e todo navegador Firefox, Chrome e Safari. O RocksDB ocupou o mesmo nicho uma camada abaixo: o paper o descreve como “projetado como um componente de biblioteca embutido em aplicações de nível mais alto”“designed as a library component that is embedded in higher-level applications”.
Dentro do Facebook ele cresceu rápido: o ZippyDB foi implantado pela primeira vez em 2013, depois veio o MyRocks, e em 2021 o paper conta “mais de 30 aplicações diferentes, armazenando no total muitas centenas de petabytes de dados de produção”“over 30 different applications, in aggregate storing many hundreds of petabytes of production data”.
Fora, a PingCAP construiu o TiKV sobre ele “porque o RocksDB é maduro e de alto desempenho”“because RocksDB is mature and high-performance”. O YugabyteDB, fundado por três ex-engenheiros do Facebook, constrói sua camada de storage sobre “uma versão altamente customizada e otimizada do RocksDB”“a highly customized and optimized version of RocksDB”, com uma instância por tablet. O arquivo de usuários do repositório lista LinkedIn, Netflix, Kafka Streams, Flink e FoundationDB, o que coloca o RocksDB dentro da Apple e da Snowflake.
É nesse sentido que o RocksDB virou o SQLite dos storage engines (nosso enquadramento, não uma citação): quase ninguém o instala diretamente. Você instala um banco de dados, um processador de streams ou uma fila, e o RocksDB vem junto por baixo.
Quando escolher, e como olhar por dentro
O RocksDB serve quando você precisa de um engine embutido em flash local e consegue medir seu workload, ou herdar configurações que alguém já ajustou. Serve pior quando o object storage é a fonte da verdade (veja bancos de dados em object storage), ou quando uma fronteira de linguagem fica no seu caminho crítico (por que o CockroachDB trocou o RocksDB).
Para ver por conta própria, compile o repositório e rode o db_bench, sua ferramenta de benchmark. As estatísticas de compaction do arquivo LOG imprimem uma linha “Write Stall (count)” com um contador por causa. Para números entre releases, Mark Callaghan, a quem o paper agradece como “o mentor do projeto por anos”“the mentor to the project for years”, faz benchmark do RocksDB versão após versão no blog dele, o Small Datum.
O que o RocksDB realmente é
Uma LSM tree guarda escritas em memória, faz flush de sorted runs para o disco e faz a compaction deles em background. O RocksDB é no que esse último passo se transforma quando precisa acompanhar um servidor: mais threads, três medidores e um knob para cada custo. Uma biblioteca que serve para todo mundo pede que todo mundo a ajuste, e para o time que construía o CockroachDB esse preço ficou alto demais, como mostra a história de por que o CockroachDB trocou o RocksDB.
Fontes e leitura complementar
Fontes
- RocksDB, Initial checkin. (f67e15e), 2011
- Google, LevelDB
- RocksDB, Print log message when we are throttling writes. (338939e), 2012
- RocksDB, The mega-patch, multi-threaded compaction (1ca0584), 2012
- Dong et al., Evolution of Development Priorities in Key-value Stores Serving Large-scale Applications: The RocksDB Experience, FAST ’21
- Dean and Ghemawat, LevelDB: A Fast Persistent Key-Value Store, 2011
- Cockroach Labs, Pebble: a RocksDB-inspired key-value store written in Go
- Facebook Engineering, Under the Hood: Building and open-sourcing RocksDB, 2013
- RocksDB Wiki, Write Stalls
- LevelDB source: db/dbformat.h, table/filter_block.cc
- Dhruba Borthakur, The History of RocksDB, 2013
- RocksDB Wiki, Options File
- RocksDB Wiki, Tuning Guide
- facebook/rocksdb source, advanced_options.h, column_family.cc
- RocksDB Wiki, Universal Compaction
- Matsunobu, MyRocks: A space- and write-optimized MySQL database, 2016
- RocksDB Wiki, Bloom Filter
- Dillinger and Walzer, Ribbon filter: practically smaller than Bloom and Xor, 2021
- Dillinger, Ribbon filter: Practically smaller than Bloom and Xor, Meta Engineering, 2021
- SQLite, Most Widely Deployed and Used Database Engine
- Masti, ZippyDB, Meta Engineering, 2021
- TiKV, RocksDB in TiKV
- RocksDB, USERS.md
- YugabyteDB, DocDB architecture
- YugabyteDB, About
- Mark Callaghan, Small Datum
- RocksDB Wiki, Column Families
- PingCAP, RocksDB overview
- tikv/tikv
- cockroachdb/pebble
- Dong, Dynamic Level Size for Level-Based Compaction, 2015
- RocksDB Wiki, Leveled Compaction
- Carter, Floyd, Gill, Markowsky, Wegman, Exact and approximate membership testers, STOC 1978
- Contagens próprias a partir de clones locais: linhas de código e data members das structs públicas de opções
Leitura complementar
- RocksDB, ribbon_alg.h, o header que documenta a construção do Ribbon
- RocksDB, filter_policy.h, incluindo
bloom_before_level - RocksDB, db_bench e internal_stats.cc
- Relacionados: o que é uma LSM tree, a conjectura RUM, object storage para bancos de dados, por que o CockroachDB trocou o RocksDB pelo Pebble