S3: milhões de HDs, e você não pode editar um byte
Correções ao vídeo
O artigo abaixo está correto nestes pontos. O vídeo não.
- média "$5,900 a month for a terabyte of RAM" (tradução: "$5.900 por mês por um terabyte de RAM") é o preço on-demand cheio de uma r6i.32xlarge, CPUs incluídas. A instância com 1 TiB de memória mais barata (x2gd.16xlarge) custa cerca de $3.900 por mês, o que deixa a razão em relação ao S3 em cerca de 166x, não 250x.
- baixa O storage do S3 aparece como $24 por TB em um trecho e $23 em outro (terabytes binários contra decimais).
- baixa A coluna "local disk" (tradução: "disco local") mistura preços do EBS gp3 (storage de rede) com latência de NVMe local.
- média Na busca vetorial baseada em centroides, o vídeo diz que comparar a consulta com os centros dos clusters leva um round trip. O round trip baixa os centroides. A comparação acontece localmente.
Em abril de 2026, a AWS lançou o S3 Files: monte um bucket S3 como se fosse um disco de verdade. A AWS diz que aplicações baseadas em arquivos rodam sobre seus dados no S3 sem mudar o código, e a montagem é NFS puro, sem driver FUSE. Isso torna fácil acreditar numa ideia errada: a de que object storage é um filesystem com preço menor.
É outra primitiva, com outras regras, e as regras decidem como fica um banco de dados construído em cima dela. A maioria dos bancos assume um disco local, um ponto que a conjectura RUM deixa visível. Troque esse disco pelo S3 e o storage fica quase de graça, mas cada requisição custa dinheiro.
Dá para fazer seek na leitura, nunca na escrita
Num disco local você faz seek até o byte 4000 e sobrescreve quatro bytes. No S3 só a metade da leitura funciona. Um GET aceita um header Range e baixa só aquela faixa de bytes. Escrever não tem equivalente. Para mudar um byte você escreve o objeto inteiro de novo, como um objeto novo em folha.
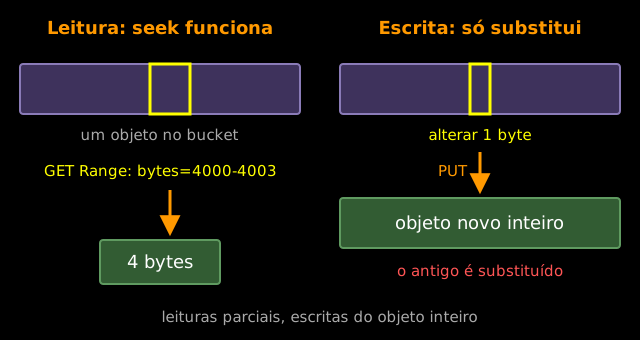
A referência do PutObject descreve o outro lado em uma frase: o Amazon S3 nunca adiciona objetos parciais. Uma escrita é tudo ou nada. O post de lançamento do S3 Files tem a explicação mais limpa: objetos são como livros numa biblioteca, e você não edita uma página, precisa substituir o livro inteiro. A documentação desse mesmo produto de filesystem afirma sem rodeios: objetos S3 são imutáveis.
Duas notas de precisão, porque essa é a afirmação com mais chance de render uma correção. Um PUT simples numa chave existente sobrescreve sim, como diz a página de conditional writes. O que você não consegue é editar bytes dentro de um objeto, só substituí-lo. E isso vale para buckets de uso geral: os directory buckets do Express One Zone aceitam appends no fim de um objeto, mas continuam sem escrita no meio.
A ironia é que o próprio S3 roda em milhões de HDs, e cada um deles sabe fazer seek. Nada desse seek chega às suas escritas.
Por mais de uma década, engenheiros trataram isso como um problema a esconder, e cada um pagou por isso. Outros leram isso como uma especificação. Guarde essa ideia, e guarde uma conta.
s3fs: o preço foi a fatura
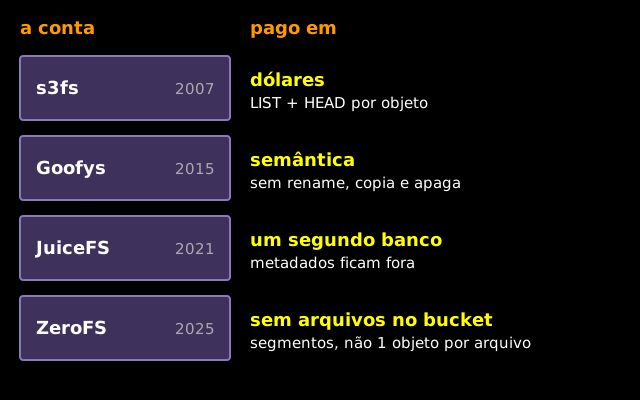
A primeira linha da conta é o s3fs, de 2007. A promessa era simples: monte o bucket, e todo programa o trata como um disco local.
As pessoas se deram a esse trabalho por causa de um número. Um terabyte em RAM custa cerca de $5.900 por mês: é uma r6i.32xlarge, uma instância otimizada para memória com 1 TiB de RAM, a $8,064 por hora on-demand em US East (a máquina inteira, CPUs incluídas). Um terabyte no S3 custa cerca de $24, $0,023 por GB, cobrado em gigabytes binários. É umas 250 vezes mais barato.
O número que ninguém cita é a contagem de requisições. Um disco lista uma pasta de graça. Com cache frio, o s3fs precisa de uma chamada de listagem a cada mil objetos mais uma requisição HEAD para cada objeto dentro, para ler os metadados do arquivo que ele guarda nos headers do objeto. O S3 cobra por requisição: $0,0004 por 1.000 GETs e HEADs, $0,005 por 1.000 PUTs e LISTs. Um milhão desses HEADs custa 40 centavos. Um bilhão custa $400. Toda listagem de diretório sem cache vira um evento de cobrança.
Isso vazou para a fatura. O FAQ do próprio projeto tem uma entrada chamada Why does my AWS S3 bill cost a lot more than the storage fee? (tradução: por que minha fatura do AWS S3 custa bem mais que o storage?) A resposta aponta para o updatedb percorrendo a montagem e fazendo chamadas ListBucket e HeadObject.
Esse é o modelo de custo em uma frase: com disco você paga uma vez e ler é de graça; com S3 o storage é barato e quase toda operação é medida. O custo não sumiu, mudou de lugar. Você para de pagar por bytes e começa a pagar por verbos.
Goofys: o preço foi a semântica
O Goofys, de 2015, pagou em outra moeda. O README brinca que ele é um Filey System, não um File System, porque busca desempenho primeiro e POSIX depois.
O README admite que não consegue renomear diretórios com mais de 1.000 filhos, mas nunca diz por quê. O código-fonte diz. O S3 não tem rename em buckets de uso geral (a chamada RenameObject existe só para o Express One Zone), então o Goofys copia cada filho um por um e depois apaga os originais em um único lote. Esse lote é o DeleteObjects, que tem teto de 1.000 chaves.
Isso não é preguiça. Um rename que é atômico num disco pode morrer no meio aqui e deixar uma cópia parcial ao lado do original. O S3 Files tem a mesma restrição e diz o que faz a respeito: objetos S3 são imutáveis e não suportam renames atômicos, então no rename ele grava os dados num objeto novo e apaga o original. É a jogada que o Goofys fez em 2015. A primitiva não mudou.
Uma nota pessoal: em 2015 abri um ticket pedindo para o Ceph, o sistema de storage open source que fala a API do S3, tornar mais rápido o seu delete de múltiplos objetos. Ele apagava cerca de dez objetos por segundo numa requisição de 500 objetos. Um fix (deletes concorrentes, relatado como 5 a 6 vezes mais rápido) foi mergeado em dezembro de 2022. Meu ticket foi marcado como resolvido em setembro de 2026. Dois sistemas guardavam o mesmo fato e discordaram por quase quatro anos.
JuiceFS: o preço foi um segundo banco de dados
O JuiceFS, aberto como open source em janeiro de 2021, chegou mais perto fingindo menos. Ele divide arquivos em blocos (máximo padrão de 4 MB), trata o object storage como um armazém burro de blocos e mantém o namespace num metadata engine separado.
As listagens ficaram rápidas e os renames, baratos. Mas uma montagem compartilhada agora roda dois sistemas com estado em vez de um. É um segundo sistema para te acordar de madrugada e um segundo para fazer backup. O JuiceFS faz backup dos metadados no object storage a cada hora, mas se você perder o banco e esses backups, o bucket vira só blobs numerados: você não consegue encontrar o arquivo original diretamente no object storage.
O que uma primitiva só de substituição te dá
Três linhas, três preços diferentes, uma causa: você não edita um objeto, só o substitui. Isso soa como uma limitação. É também uma garantia.
Em agosto de 2024 o S3 transformou essa garantia numa ferramenta. As conditional writes criam um objeto somente se ninguém o criou ainda. Dois nós disputam uma chave com If-None-Match: *. A primeira escrita a terminar tem sucesso, e o S3 falha as outras com 412 Precondition Failed.
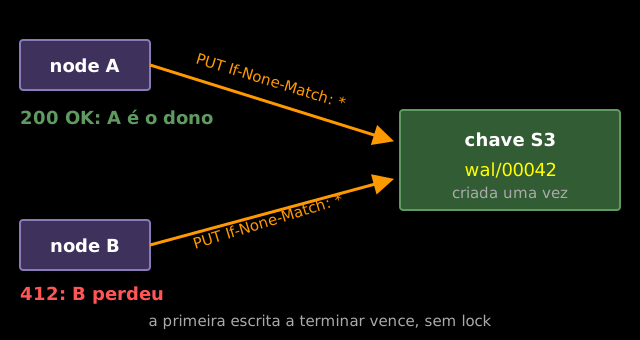
Quem ganha a corrida é dono da chave. Repare no escopo: essa é a forma criar-se-ausente. O compare-and-swap num ETag com If-Match chegou separadamente, em novembro de 2024.
Agora compare isso com a estrutura de uma LSM tree, que acumula escritas em memória e faz flush delas como sorted runs. Sorted runs são escritas uma vez e nunca modificadas. A compaction também não as edita: ela escreve uma run nova e descarta as antigas. O object storage exige imutabilidade, e a LSM tree já tinha isso. Todo wrapper de filesystem teve de resolver como editar um byte sem substituir o objeto inteiro. Uma LSM nunca precisa resolver esse problema.
O triângulo RUM a preços de S3
A estrutura se encaixa na primitiva. A pergunta seguinte é o que a primitiva faz com os trade-offs. Pegue o triângulo RUM, que diz que um método de acesso troca overheads de leitura, atualização e memória (espaço) entre si (mais sobre a conjectura RUM), e veja o que muda.
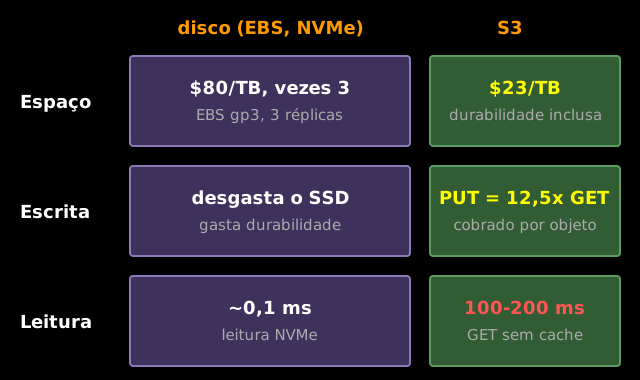
O espaço deixa de importar. No EBS, um terabyte extra de gp3 custa $80 por mês, e um banco replicado paga isso três vezes. No S3 são cerca de $23, com onze noves de durabilidade em pelo menos três Availability Zones já no preço. O space amplification deixou de ser o canto com o qual se preocupar.
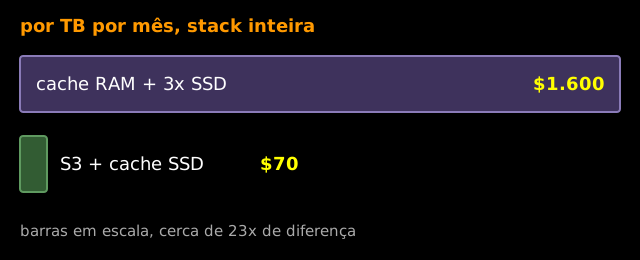
A stack inteira conta a mesma história. A turbopuffer publica uma tabela de custo por terabyte por mês: três réplicas em SSD com metade dos dados em cache na RAM custam $1.600, e S3 com cache em SSD custa $70. É cerca de 23 vezes mais barato.
Escritas viram dinheiro. Num disco local, o write amplification desgasta o SSD. No S3 cada reescrita é um PUT, e um PUT custa $0,005 por 1.000 contra $0,0004 de um GET, doze vezes e meia mais. O write amplification virou fatura, cobrada por objeto, não por byte.
A boa notícia é que o S3 oferece exatamente um tipo de escrita, e é o que uma LSM faz. Uma run que sofreu flush, uma run gerada por compaction e um segmento de log finalizado são todos escritos inteiros.
A leitura é a assassina. Em NVMe local, checar mais uma sorted run leva cerca de um décimo de milissegundo. No S3, a AWS documenta latências de primeiro byte de aproximadamente 100 a 200 milissegundos. No S3, o read amplification é o que te mata.
É por isso que a metade da leitura na assimetria importa. Uma LSM no S3 mantém seus Bloom filters e o índice de blocos em cache, e então puxa só o bloco de que precisa com um único GET parcial. O seek na leitura é o único seek de que uma LSM precisa.
Onde fica a linha? Se sua consulta pode esperar um segundo, ler direto do S3 funciona. A própria documentação da turbopuffer mostra uma consulta fria em p50 de 874 ms contra 14 ms quente, para um milhão de documentos. Se um usuário está olhando um spinner, você precisa de um cache na frente. Mesmos dados, tolerância diferente à espera, fatura diferente.
turbopuffer: desenhada em torno da fatura
Simon Eskildsen passou oito anos na Shopify, muito tempo de plantão. Na palestra dele na CMU:
the only database that I would go on call for was one where I didn’t have to write the storage layer
(tradução: o único banco de dados pelo qual eu aceitaria ficar de plantão era um em que eu não precisasse escrever a camada de storage)
Então a única dependência com estado da turbopuffer é o object storage. Na palestra ele diz que ela serve mais de três trilhões de vetores e documentos em produção, e que no lançamento cobrava cerca de um dólar por milhão de vetores por mês, quando as concorrentes cobravam perto de cem.
O algoritmo padrão para busca vetorial é o HNSW, um grafo que você percorre salto a salto. No S3 cada salto é um GET, e cada um custa cerca de cem milissegundos. Digamos dez saltos, e você esperou um segundo inteiro (dez é um exemplo, os cem milissegundos por salto vêm da palestra).
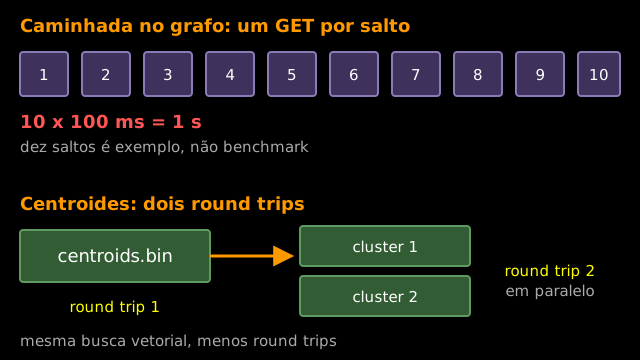
A turbopuffer nunca usou esse algoritmo. Seu índice vetorial é baseado no SPFresh, um índice baseado em centroides, que agrupa vetores em clusters. Baixar os centros dos clusters (centroids.bin) leva um round trip, e comparar a consulta com eles acontece em memória. Buscar os clusters mais próximos, todos de uma vez, leva mais um. Dois round trips em vez de dez. A documentação da turbopuffer diz que o design com centroides minimiza round trips e write amplification em comparação com índices de grafo como o HNSW.
Tonbo: deixe o S3 escolher o formato de arquivo
A turbopuffer deixou o S3 escolher o algoritmo. O Tonbo deixa ele escolher o formato de arquivo. É uma LSM tree sobre object storage: um WAL, uma MemTable e um flush que escreve cada run no S3 como um arquivo Parquet.
Os arquivos que seu banco escreve são Parquet, um formato que DuckDB, Spark e Pandas já leem. Sem job de exportação, sem segunda cópia. Pelo manifest do Tonbo existe uma única versão da verdade.
O preço está nas buscas pontuais. Um índice de SSTable customizado cai num bloco pequeno de alguns kilobytes. O Parquet cai numa página feita para scans, muitas vezes de megabytes, o que deixa leituras de uma linha mais lentas e scans baratos.
SlateDB: o S3 como único disco
Onde o Tonbo mudou o formato, o SlateDB muda o caminho de escrita. Chris Riccomini e Rohan Desai o construíram em torno de uma ideia direta: o S3 como único disco. A MemTable continua na memória. Os flushes e o write-ahead log vão direto para o S3. Um disco local é, no máximo, um cache.
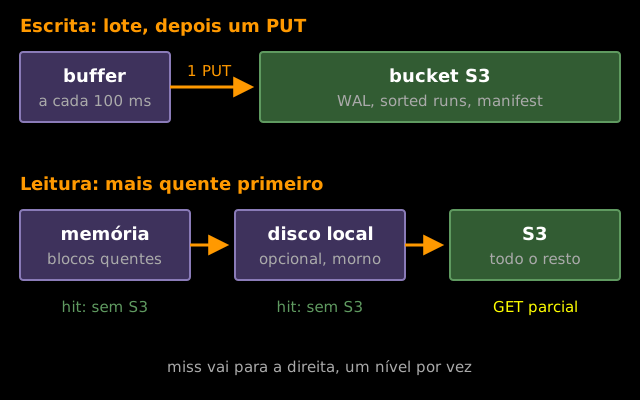
O caminho de escrita. Uma escrita durável espera pelo seu lote e depois o S3 confirmar o PUT, que sozinho leva de 50 a 100 milissegundos no S3 Standard. Isso é lento para os padrões de disco local. Mas quando o S3 diz OK a escrita é durável, e todas as máquinas do seu cluster podem morrer enquanto seus dados sobrevivem.
O SlateDB também evita pagar um PUT por escrita. As escritas se acumulam num buffer, e a cada 100 milissegundos por padrão o lote inteiro sai como um único PUT. Essa é a resposta dele ao canto da escrita: gastar menos verbos.
Compaction, com preço. A compaction é a outra metade da fatura. Ela lê runs com GETs e escreve novas com PUTs. Com compaction eager você paga em PUTs. Com compaction lazy cada leitura paga em GETs. É o trade-off RUM de novo, agora com etiqueta de preço.
As conditional writes voltam. Se dois escritores do SlateDB disputam a próxima entrada do WAL, um vence e o outro é barrado: cada arquivo de WAL é escrito exatamente uma vez, com a mesma primitiva criar-se-ausente. Sem split-brain, sem cluster Raft para operar.
O caminho de leitura. O SlateDB responde ao canto da leitura com cache: a memória guarda os blocos mais quentes, um cache opcional em disco local guarda os mornos, e o S3 guarda o resto. Leituras quentes nunca tocam o S3.
Isso resolve a linha do JuiceFS na conta. O JuiceFS pôs seus metadados num segundo sistema com estado. O SlateDB mantém os dele, o manifest, no próprio S3. Um sistema a menos, não um a mais.
Uma exceção: para um log mais rápido, o SlateDB pode pôr o WAL num object store separado como o S3 Express One Zone, com milissegundos de um dígito. Os PUTs ali custam cerca de 77 por cento menos e o storage custa cerca de cinco vezes mais por GB. Verbos baratos e bytes caros é exatamente o que um write-ahead log quer.
Isso tem nome: diskless
Construir com o S3 como único disco agora tem nome. O post introdutório do SlateDB de junho de 2026 diz que sistemas “diskless” que delegam a durabilidade ao object storage são o futuro dos sistemas de banco de dados (tradução livre do inglês “diskless”). O padrão é mais amplo que um projeto: os nós de computação do ClickHouse Cloud largaram seus discos locais, o InfluxDB 3 pode rodar diskless com object storage como única camada de persistência, e a WarpStream construiu o Kafka sobre object storage, e depois foi adquirida pela Confluent.
Dois filesystems sobre o S3, arquiteturas opostas
De volta à conta. Em julho de 2025 Pierre Barre lançou o ZeroFS: um bucket servido como filesystem POSIX via NFS, construído sobre o SlateDB. Nove meses depois a AWS lançou o S3 Files, que também serve arquivos via NFS.
Os dois resolvem o mesmo problema com arquiteturas opostas. A AWS construiu o dela sobre o EFS e manteve um arquivo como um objeto, então o bucket continua legível normalmente. O ZeroFS abriu mão disso: o conteúdo dos arquivos é dividido em extents e empacotado em seus próprios objetos de segmento comprimidos, com os metadados numa LSM tree. Desde seu storage engine 2.0, a LSM guarda só metadados.
Feche a conta. O s3fs pagou em dólares. O Goofys pagou em semântica. O JuiceFS pagou com um segundo banco de dados. O ZeroFS pagou com um bucket que você não consegue ler como arquivos, mas, por baixo, ele parou de fingir: ele se descreve como um filesystem log-structured para S3.
E a resposta da AWS? Andy Warfield, do time do S3, escreveu que em vez de tentar esconder, a própria fronteira era o recurso que precisávamos construir (tradução do original em inglês). Para te dar um filesystem, eles puseram um de verdade na frente do bucket. Os bancos de dados feitos para o S3 nunca tentaram esconder a fronteira.
Mesmo mapa, preços novos
A receita da LSM continua valendo (acumular, fazer flush, fazer compaction), mas o disco agora é o S3, um flush é um PUT que custa dinheiro, e a compaction significa decidir quais PUTs valem o preço. Ponha os três sistemas de volta no triângulo. A turbopuffer vive do canto da leitura. O SlateDB vive do canto da escrita. O Tonbo fica entre leitura e espaço. Os trade-offs continuam valendo e você continua sem poder ter tudo. Só os preços mudaram.
Muito antes de qualquer um deles existir, um storage engine já rodava LSM trees em escala de Facebook em disco local, construído em torno exatamente dos trade-offs de read, write e space amplification que viemos precificando aqui. Esse storage engine é o RocksDB, tratado em RocksDB, o SQLite dos storage engines. As ideias que ele aperfeiçoou em disco local são as que esses sistemas estão reprecificando para o S3.
Fontes e leitura complementar
Fontes
- AWS, S3 pricing
- AWS, EC2 on-demand pricing
- AWS, EBS pricing
- AWS, Amazon S3 now supports conditional writes
- AWS, How to prevent object overwrites with conditional writes
- AWS, Optimizing Amazon S3 performance
- AWS, S3 Express One Zone
- AWS, S3 storage classes
- AWS, PutObject API reference
- AWS News Blog, Launching S3 Files
- AWS, S3 Files synchronization
- AWS, Mounting S3 Files
- Andy Warfield, S3 Files and the changing face of S3, 2026
- Sirupsen, napkin-math
- s3fs-fuse, FAQ
- kahing, Goofys
- JuiceFS, Architecture
- Pierre Barre, ZeroFS
- Ceph, Feature #11326: rgw: make MultiDelete faster, PR 48679, RADOS Gateway docs
- Athanassoulis et al., Designing Access Methods: The RUM Conjecture, EDBT 2016
- Simon Eskildsen, CMU database talk on turbopuffer
- turbopuffer, launch post and cost table and architecture
- Malkov and Yashunin, HNSW
- Xu et al., SPFresh, SOSP 2023
- Tonbo, tonbo-io/tonbo
- SlateDB, slatedb.io and slatedb/slatedb
- Riccomini and Desai, Building a cloud-native LSM on object storage
- ClickHouse, ClickHouse Cloud stateless compute
- InfluxData, InfluxDB 3 OSS GA
- WarpStream, Kafka is dead, long live Kafka
- Facebook Engineering, Under the Hood: Building and open-sourcing RocksDB, 2013
- Dong et al., RocksDB: Evolution of Development Priorities, ACM TOS 2021
Leitura complementar
- Andy Warfield, Building and operating a pretty big storage system called S3, 2023
- AWS, GetObject, DeleteObjects and RenameObject API references
- AWS, conditional compare-and-swap with If-Match, November 2024
- JuiceFS, open-sourcing announcement and metadata backup
- Goofys, directory rename source
- SlateDB, An Object-Native LSM for Online Systems (2026), tuning, manifest and fencing RFC and separate WAL store RFC
- Tonbo, Introducing Tonbo