SlateDB: e se o S3 fosse o seu único disco?
O banco mais simples que você consegue montar em cima do S3 dá um objeto para cada chave: um PUT por escrita, um GET por leitura. O post de lançamento do SlateDB coloca preço nesse design:
A naive system that uses S3 directly as a key-value store for a modest 10K ops/sec split even between reads and writes would cost $70K/mo and perform poorly.
(tradução: Um sistema ingênuo que usa o S3 diretamente como key-value store, para modestos 10 mil ops/s divididas igualmente entre leituras e escritas, custaria $70 mil por mês e teria desempenho ruim.)
Quase toda essa conta são PUTs, que o S3 cobra a $0,005 por 1.000 contra $0,0004 do GET. O SlateDB constrói um banco de verdade no mesmo bucket sem pagar isso, e o mantém seguro sem nenhum coordenador, desde que o bucket se comporte de fato como o S3.
Alguns números vêm do “meu teste”, um pequeno serviço de key-value que eu rodo em cima do SlateDB (um writer, quatro bancos, compute na DigitalOcean em Nova York). Não é produção. O storage dele saiu do DigitalOcean Spaces para o Cloudflare R2 em junho de 2026, e toda medição de sete dias foi feita depois disso. Ele roda uma versão anterior à v0.15.
Uma biblioteca de key-value com um bucket no lugar do disco
O SlateDB é um storage engine embarcado, construído como uma log-structured merge-tree, que grava seus dados em object storage. Chaves e valores são bytes puros, ordenados por chave, e a interface é put, get, delete e um scan sobre um intervalo. Não existe servidor: é uma biblioteca linkada no seu programa, como o RocksDB, só que onde o RocksDB tem um disco local, o SlateDB tem um bucket.
Chris Riccomini e Rohan Desai começaram o projeto em março de 2024 sob Apache 2.0. O núcleo é em Rust, com bindings para Go, Java, Node e Python. Cada banco tem exatamente um processo writer; qualquer número de readers pode abrir o mesmo bucket a partir de outras máquinas sem nunca falar com o writer (o RFC 0001 definiu esse modelo). Ele também tem transações, merge operators, TTL nas chaves e clones, que começam como cópia de outro banco sem copiar seus arquivos.
Por baixo, é a mesma árvore de qualquer outra LSM: uma MemTable e um log, flushes para arquivos ordenados, compaction em background. O design overview diz “the only difference is that all of SlateDB’s data is written to object storage” (tradução: a única diferença é que todos os dados do SlateDB são gravados em object storage). O que mudou foi o endereço de cada arquivo: wal/, compacted/, manifest/, compactions/ e gc/ são pastas em um bucket.
Três propriedades do bucket guiam toda decisão de design (detalhes): uma requisição leva dezenas de milissegundos, toda leitura e escrita é cobrada seja qual for o tamanho, e um objeto é substituído inteiro ou não é substituído.
Escritas viajam em lotes
As escritas se acumulam na memória, e um timer as envia juntas como um único objeto numerado no write-ahead log, a cada 100 ms por padrão.
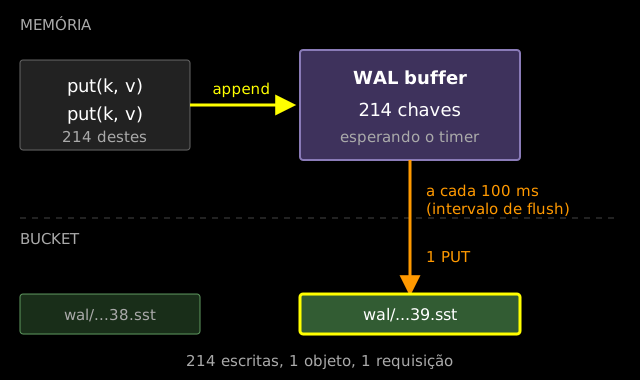
Em uma semana, meu teste escreveu 358 milhões de chaves. Elas chegaram ao bucket em 1,67 milhão de objetos de log, cerca de 214 chaves por upload. Contando as leituras, a conta de requisições fica em cerca de $45 por mês nos preços de tabela do R2. Um objeto por chave custaria cerca de $7.000 por mês nos mesmos preços (minha conta: 358 milhões de PUTs por semana a $4,50 por milhão, mais as leituras).
O preço de uma escrita durável
O lote é pago em tempo. Desses 1,67 milhão de uploads, três terminaram em 100 ms ou menos; 87% levaram entre 100 e 250 ms. O compute do meu teste fica na DigitalOcean e o storage no R2, então todo upload cruza a internet pública; o número de 50 a 100 ms supõe S3 na mesma região.
Então o SlateDB pode dizer OK em dois momentos. Quando a escrita está na memória, a mediana no meu teste foi 2,5 ms. Quando está no bucket, um flush levou 216 ms na mediana e 885 ms no percentil 99. Desde a v0.16, o put retorna na hora com um handle; esperar por ele (await_durable) significa que a escrita está no bucket. Não esperar é mais rápido, mas se o processo morrer antes do próximo flush, essa escrita se perdeu.
É um triângulo de latência, custo e durabilidade, em que você leva dois, e o intervalo de flush é o botão:
| Intervalo de flush | Espera no pior caso | PUTs de log por mês, writer ocupado |
|---|---|---|
| 100 ms | 100 ms mais o upload | cerca de 26 milhões |
| 1 s | 1 s mais o upload | cerca de 2,6 milhões |
| 60 s | um minuto de escritas em risco num crash | cerca de 43 mil |
A tabela é aritmética a partir do padrão e da documentação, não medição. Meu teste configura o timer para 60 segundos e quase não o usa. Ele lê do Kafka e faz flush de todos os bancos antes de fazer commit dos offsets, então um crash reprocessa desde o último commit e o log durável está a montante.
Fencing de um writer com um nome de arquivo
“Exatamente um writer” é fácil de dizer e difícil de garantir, porque um writer pode congelar ou perder a rede e depois voltar ainda achando que manda. O bucket não faz ideia de qual processo é o writer.
A lista de arquivos que formam o banco vive em um único objeto, o manifest: quais sorted runs existem, onde começa o replay do log, e dois contadores, o writer epoch e o compactor epoch. O SlateDB nunca o edita. Cada nova versão é um novo objeto com o próximo número no nome.
Cada versão é criada com If-None-Match: *: crie este objeto somente se ele não existir, algo que o S3 suporta desde agosto de 2024. Dois processos que tentam criar o manifest 8 não podem ter sucesso os dois: um recebe 200, o outro 412.
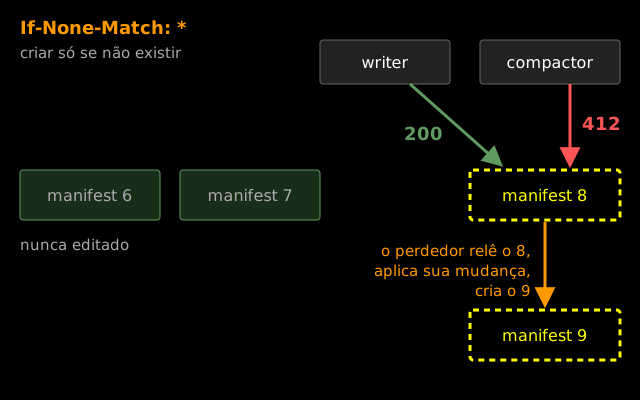
O perdedor relê o manifest 8, aplica sua própria mudança por cima e tenta criar o 9. É assim que o writer e o compactor dividem um manifest sem lock.
O post de lançamento chama o protocolo de baseado em APIs de escrita condicional IF-MATCH, mas o código cria manifests, objetos de log e arquivos de job de compaction com o header create-only. O If-Match aparece só nos arquivos de boundary do garbage collector, tratados mais abaixo.
O epoch e o fence de zero bytes
O fencing é um passo separado. Um novo writer que abre o banco cria um manifest com o writer epoch mais um. O RFC define um zombie como um writer cujo epoch é menor que o epoch do manifest atual. Mas como o zombie descobre?
O novo writer também cria um objeto vazio, de zero byte, no próximo número do log. Os objetos de log são numerados e criados com o mesmo header, então o próximo flush do zombie tenta criar esse mesmo objeto e recebe um 412, que o SlateDB mapeia para Fenced.
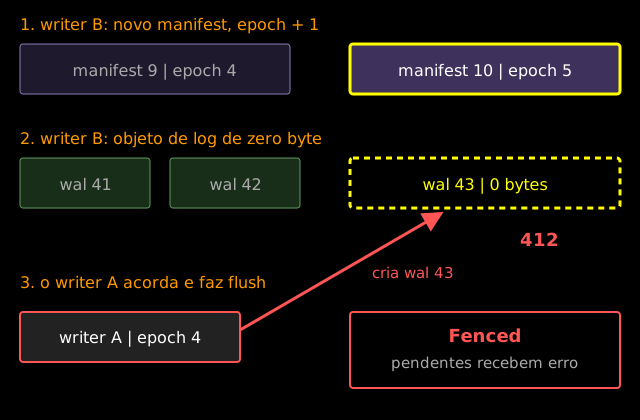
O zombie se fecha como fenced, e toda escrita que ainda esperava ficar durável recebe um erro em vez de um OK que não é verdade. Não há lease nem coordenador: o zombie só consegue trabalhar até o próximo flush, e o novo writer faz replay de tudo que ele tornou durável antes do fence.
Isso aconteceu comigo. Em junho, um rolling update do Kubernetes subiu meu pod novo antes de parar o antigo. Os dois writers se fecharam mutuamente em loop e, com os restarts daquele dia, o writer epoch chegou a 33. Nada foi corrompido, e a correção foi uma linha: Recreate, que para o pod antigo primeiro.
Por que o cache não serve um bloco velho
Todo processo do SlateDB faz cache de blocos em memória e, opcionalmente, em disco local. Os arquivos de sorted run são nomeados com um ULID, um ID único que começa com um timestamp, e a compaction grava sua saída com nomes novos. Um arquivo pode ser apagado, mas nunca reescrito com o mesmo nome. A chave do cache inclui o ID do arquivo, então um bloco em cache está correto enquanto o arquivo existir. Nada precisa ser invalidado.
Escritas condicionais fazem fencing de writers, não de caches. A única coisa que muda é o manifest, e nenhum processo confia por muito tempo na sua cópia: por padrão o writer o reverifica a cada segundo e um reader separado a cada 10 segundos. Um reader pode estar um pouco atrasado, nunca errado.
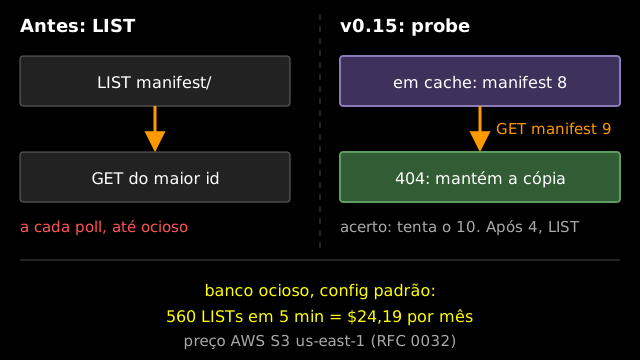
Verificar costumava significar listar a pasta manifest/ inteira. O RFC 0032 mudou isso na v0.15.0. Cada processo guarda os bytes do último manifest e pergunta pelo próximo número: um GET do id N+1. Um 404 significa que nada mudou, então ele mantém sua cópia. Depois de quatro acertos consecutivos ele volta a fazer um LIST, e um store frio lista uma vez. Meu teste é anterior a essa versão, então ainda lista. A motivação do RFC:
A database that’s idle for five minutes incurs 560 LIST requests with default configuration. This comes out to $24.19 per-month in AWS S3 us-east-1 pricing.
(tradução: Um banco ocioso por cinco minutos gera 560 requisições LIST com a configuração padrão. Isso dá $24,19 por mês no preço do AWS S3 us-east-1.)
Os Bloom filters também mantêm as leituras longe do bucket: em uma semana meu teste evitou 120 milhões de leituras de arquivo, com taxa de falso positivo de 0,81% contra o padrão de 10 bits por chave, e 98,8% dos lookups de bloco foram servidos da memória.
Compaction como quadro de jobs
A compaction reescreve sorted runs em novas e depois altera o manifest para trocá-las. Então o compactor é um segundo writer do manifest, com seu próprio epoch verificado do mesmo jeito.
Desde a v0.14, a compaction é dividida em duas partes. Um coordenador grava jobs de compaction em um arquivo numerado no bucket; os workers reivindicam um job com a mesma escrita create-only. Um worker manda um heartbeat a cada 10 segundos e não guarda estado; se ele morre, seu job volta ao quadro depois de 30 segundos, então os workers podem ser máquinas baratas que podem sumir. Por padrão tudo isso roda dentro do processo do writer, como no meu teste, onde as escritas nunca sofreram stall durante a semana toda.
Apagar um nome o reabre
Alguém ainda precisa apagar arquivos: o garbage collector. Mas apagar um arquivo numerado reabre o nome dele. O RFC 0026 descreve o risco:
A stalled writer can prepare file
N+1, another writer can create and supersedeN+1, GC can later deleteN+1, and the stalled writer can then resume and successfully create the same filename.
(tradução: Um writer parado pode preparar o arquivo N+1, outro writer pode criar e superar o N+1, o GC pode depois apagar o N+1, e o writer parado pode então retomar e criar com sucesso o mesmo nome de arquivo.)
Então, antes de apagar qualquer coisa, o garbage collector sobe uma boundary, guardada em um arquivo pequeno só dela, e apaga somente arquivos com número igual ou menor. Depois de cada create bem-sucedido, um writer confere a boundary e trata um número igual ou menor como falha.
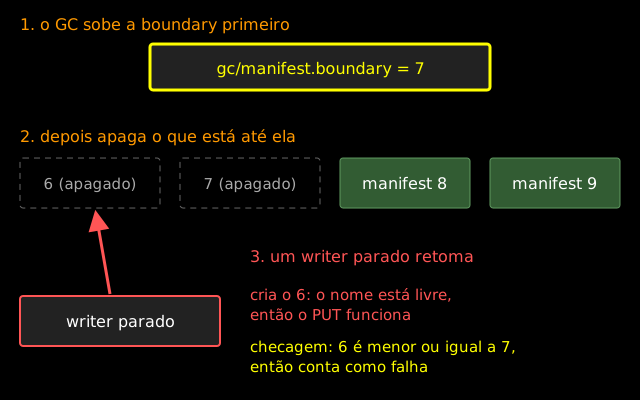
Os arquivos de boundary são os únicos objetos que o SlateDB substitui, o que os torna o único lugar que precisa do outro header condicional. If-Match significa: substitua este objeto somente se a tag de versão dele, o ETag, ainda for a que eu li. O HTTP envia o ETag entre aspas, e os clientes S3 o devolvem como o receberam.
Quando o bucket não é bem S3
Meu teste começou no DigitalOcean Spaces, em Nova York. Algumas semanas depois, o bucket tinha 38 GB e o banco dentro dele precisava de cerca de 44 MB, ou seja, 99% do bucket era lixo. Toda escrita tinha dado certo e toda leitura devolvia o valor certo. O garbage collector estava rodando, tentando umas 23 vezes por segundo, e não tinha apagado nada. A boundary dele estava em 144 enquanto os manifests tinham chegado a 57.649.
A causa foi um header, na requisição que move o arquivo de boundary. O create-only funcionava, então escritas, leituras e fencing iam bem, mas em 15 de junho o store passou a devolver 412 para todo If-Match, mesmo com a tag certa. Uma semana depois a forma sem aspas passou a funcionar, enquanto a forma com aspas, a que o HTTP especifica e os clientes reais enviam, continuava falhando:
PUT gc/manifest.boundary
If-Match: "a1b2c3"      ->  412 Precondition Failed
If-Match: a1b2c3        ->  200
Eu tinha checado isso em março, antes de o teste começar, e passou, em parte porque meu script de teste tirava as aspas antes de enviar a tag. O cliente real não tira, então a checagem testava uma requisição que ninguém envia.
Não esperei por uma correção: em poucos dias movi o storage para o R2, que suporta escritas condicionais desde 2022. Chris Riccomini abriu uma issue citando a DigitalOcean e, em poucas semanas, uma chave para desligar os arquivos de boundary saiu na v0.15. Com a chave desligada, a única proteção é a espera do collector antes de apagar, então a documentação pede um min_age maior que o tempo de vida de qualquer processo velho.
Em 9 de julho a DigitalOcean liberou uma correção em uma região: um bucket novo em Richmond aceitou a tag com aspas, um novo em Nova York ainda recusava. O Spaces é construído sobre Ceph, e a DigitalOcean roda 75 clusters Ceph para block e object storage, então meu palpite é que uma correção pode chegar a uma região antes de outra. Em 8 de outubro, um bucket de junho e outro criado em setembro, ambos em Nova York, ainda devolviam 412 para a tag com aspas e 200 para a sem aspas.
Não é erro de um provedor só: uma nuvem de pesquisa universitária em Ceph relatou a mesma falha (a medição de um usuário). E o MinIO, o store que muita gente usa para testar localmente, tira as aspas antes de comparar, então os testes no laptop passam.
Falhas barulhentas são seguras
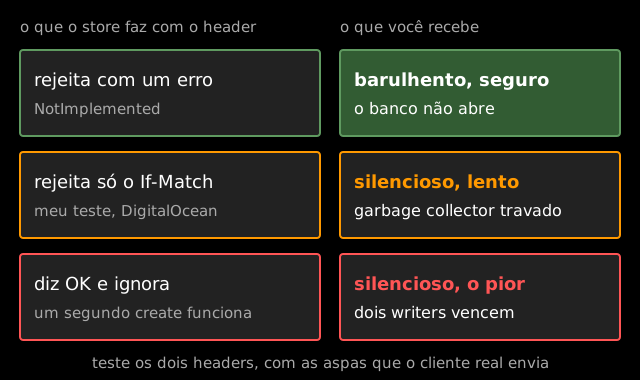
Um store que rejeita o header com erro, como a OVH fazia antes de adicionar suporte e como a Alibaba OSS documenta, falha de forma barulhenta: o banco não abre. Um store que rejeita só o If-Match falha devagar, como o do meu teste. O pior caso é dizer OK e ignorar o header: um usuário relata que a camada de interoperabilidade S3 do Google Cloud Storage faz isso. Aí, pela minha leitura do código create-only, dois writers podem criar o manifest 8 e ambos acreditam que venceram. O arquivo de fence também é sobrescrito, então o zombie nunca ouve seu 412, e escritas confirmadas podem sumir.
Então, antes de confiar em um store que se diz compatível com S3, teste os dois headers do jeito que o cliente real os envia: crie o mesmo objeto duas vezes (a segunda precisa receber 412), substitua um com seu ETag entre aspas (200) e substitua um com um ETag errado (412 de novo).
Quando escolher, e quando não
Escolha o SlateDB quando um writer basta e você prefere pagar por requisição a operar discos, de modo que qualquer máquina possa morrer sem perder uma escrita durável. O post de lançamento cita Dropbox e ZeroFS entre os usuários. Evite quando uma escrita durável precisa terminar em poucos milissegundos, quando muitos processos precisam escrever no mesmo banco, ou quando os readers precisam acompanhar o writer: eles só veem escritas novas quando fazem poll, a cada 10 segundos por padrão. O primeiro limite tem saída: o log pode ir para um store mais rápido, como o S3 Express One Zone, e a v0.16 abriu a interface do log para outros backends (o RFC ainda é rascunho; só o log em object store vem pronto).
Ele também ainda evolui rápido: a v0.17.0 saiu em 29 de setembro de 2026, e os recursos mais novos carregam mais risco. Em 2 de outubro, o PR #2132 fez merge de uma correção para um bug de perda de dados em union clones, que juntam vários bancos em um:
Fix data loss after union clones combine L0 views with the same ID. Compaction can read one view but remove several.
(tradução: Corrige perda de dados depois que union clones combinam views L0 com o mesmo ID. A compaction pode ler uma view mas remover várias.)
O PR “only prevents the bug. It does not repair existing manifests or restore lost data” (tradução: apenas previne o bug. Não repara manifests existentes nem recupera dados perdidos). Só são afetados bancos criados por union clones ou projected clones, e a v0.17.0 ainda tem o bug.
O SlateDB não tem disco, só um bucket e algumas regras sobre nomes de arquivo, então toda garantia que ele dá é exatamente tão forte quanto a implementação de dois headers condicionais pelo store.
Fontes e leitura complementar
Fontes
- SlateDB, Introducing SlateDB, launch post, 2026-06-30.
- SlateDB, design overview and tuning guide.
- SlateDB, RFC 0001: Manifest, RFC 0002: Compaction, RFC 0025: Distributed compaction, RFC 0026: GC boundary, RFC 0030: Pluggable WAL, RFC 0032: Cached probing.
- SlateDB source: object_store.rs, writer_init.rs, wal store.rs, db_cache, config.rs.
- SlateDB releases: v0.16.0, v0.17.0; PR #1968, issue #1818, PR #1917, PR #2132.
- AWS, conditional writes and S3 pricing; Cloudflare, R2 pricing and release notes.
- IETF, RFC 9110 section 8.8.3, entity tags.
- DigitalOcean on Ceph: Ceph at DigitalOcean (2021) and Ceph Operations at Scale (2025).
- Provider reports: Ceph on Jetstream2, MinIO source, OVH, Alibaba OSS, GCS interop report.
- A telemetria marcada como “meu teste” vem do meu próprio serviço, sete dias terminando em 2026-09-27; os números de 38 GB, 44 MB, 23 tentativas por segundo, boundary 144 e 57.649 manifests vêm das minhas notas do incidente de junho.
Leitura complementar
- Chris Riccomini, The Cloud Storage Triad: Latency, Cost, Durability.
- ULID specification.
- Kubernetes, Deployment strategy.
- AWS, S3 Express One Zone.
- S3: Millions of Hard Drives, and You Can’t Edit One Byte.