O que realmente existe dentro do seu banco de dados?
Correções ao vídeo
O artigo abaixo está correto nestes pontos. O vídeo não.
- média O vídeo coloca a B-tree dois anos depois do modelo relacional de Codd (1972), como se tivesse decorrido dele. O primeiro relatório de Bayer e McCreight é de julho de 1970, um mês depois do artigo de Codd, e foi um trabalho independente. 1972 é a versão de periódico.
- alta A B-tree animada desenha nós internos com duas chaves e apenas dois filhos. Um nó com duas chaves tem três filhos.
- média A busca pela chave 45 termina na folha [42, 48], que não contém o 45. Isso é um miss, e o vídeo não diz isso.
- baixa "Todo grande banco de dados roda em um de dois storage engines" é exagero. A maioria dos engines populares é baseada em B-tree ou em LSM, não todos.
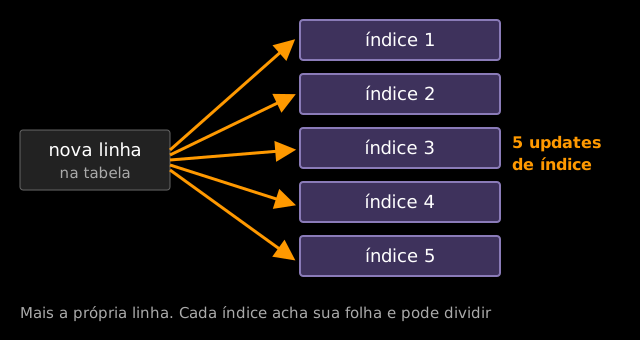
- média "Cinco índices significam cinco updates de B-tree por escrita" é amplo demais. Inserir uma linha também grava a própria linha, e um update que não muda nenhuma coluna indexada pode pular os updates de índice (o PostgreSQL faz isso).
Todo banco de dados precisa responder a uma pergunta antes de qualquer outra: quando você entrega um registro a ele, para onde vão os bytes? O componente que decide isso é o storage engine, e na maioria dos bancos que você conhece ele é construído sobre uma de duas estruturas de dados. Uma tem mais de cinquenta anos e continua sendo o padrão. A outra é a base de uma lista crescente de sistemas mais novos.
Este artigo cobre a história que faz as duas famílias fazerem sentido, e de propósito não entra em detalhes sobre como a segunda funciona. Esse é o assunto de como funciona uma LSM tree.
Por que a história importa
Storage engines parecem um problema puramente moderno, mas cada projeto é uma resposta ao hardware e ao workload da sua época. Então começamos pelo formato de armazenamento mais antigo que importa aqui.
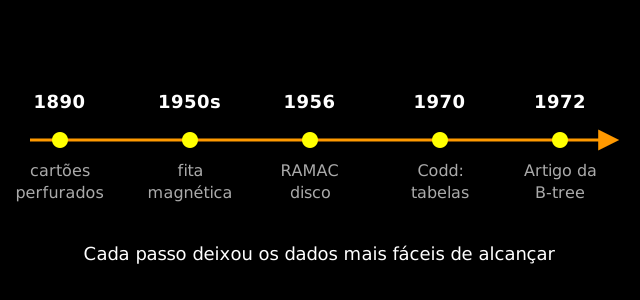
1890: furos em papel
O Census Bureau dos EUA tinha um problema. Depois do censo de 1880, ele estava coletando mais dados do que conseguia tabular, então em 1888 abriu uma competição por um método mais rápido. Herman Hollerith, ex-funcionário do Bureau, construiu uma tabuladora que funcionava “lendo” furos em cartões de papel perfurados. No teste, os outros dois concorrentes levaram 44,5 e 55,5 horas para preparar os dados para a tabulação. Hollerith levou 5,5 horas e ganhou o contrato do censo de 1890 (mesma página do Census Bureau).
Esse era o estado da arte em armazenamento de dados: um furo é um um, a ausência de furo é um zero, e o “banco de dados” é uma pilha de cartões.
Década de 1950: fita magnética
Computadores construídos com válvulas rodavam tão rápido que o armazenamento em cartões perfurados não acompanhava. A história da fita magnética segundo a IBM descreve como, a partir do início dos anos 1950, a fita aumentou muito a velocidade do processamento de dados e eliminou a necessidade de pilhas enormes de cartões perfurados.
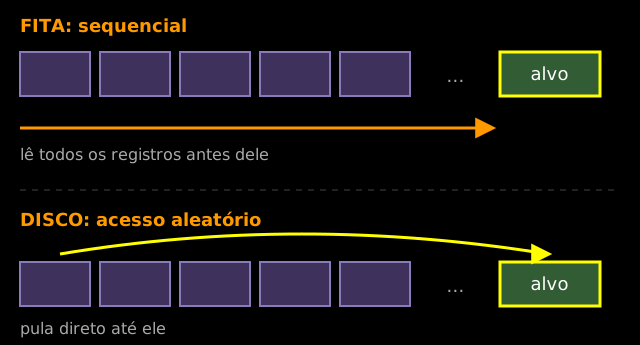
A fita tem uma propriedade que molda tudo o que vem depois: ela é lida em ordem. O acesso sequencial é a única forma de chegar aos dados de uma fita. Se o registro que você quer é o último, você percorre tudo o que vem antes. Imagine uma fita com um milhão de registros em que o que você precisa é o último: você passa por 999.999 outros para chegar a ele. Esse número é uma ilustração, não uma medição de nenhuma unidade de fita real, mas o formato do custo é real. Achar um registro custa um tempo proporcional a onde ele está na fita.
1956: o disco que sabe pular
A página da IBM sobre o 305 RAMAC o chama de primeiro computador a usar uma unidade de disco de acesso aleatório. Ele guardava 5 milhões de caracteres decimais codificados em binário, a 7 bits por caractere, tinha o tamanho de duas geladeiras de cozinha e pesava mais de uma tonelada. Pelos padrões de hoje, isso são alguns arquivos MP3, como a própria página da IBM observa.
O ponto é o padrão de acesso. Um disco de acesso aleatório permite que a máquina vá direto a um registro sem ler tudo o que está na frente. Nada de rebobinar. Isso tornou prático manter os dados em uma estrutura organizada no disco e atualizá-los enquanto a máquina funcionava. Também preparou a pergunta que o resto deste artigo trata: se você pode pular para qualquer lugar, como organizar o que está guardado para que pular seja barato?
1970: tabelas
Em junho de 1970, E. F. Codd, do IBM Research Laboratory em San Jose, publicou A Relational Model of Data for Large Shared Data Banks na Communications of the ACM. O artigo descreve os dados como relações, que Codd representa como arrays em que cada linha é uma tupla e cada coluna leva o nome do seu domínio. Hoje chamamos isso de tabelas, linhas e colunas.
A ideia precisava de algo por baixo. Uma tabela só é útil se você consegue achar uma linha entre milhões rapidamente, e continuar achando enquanto novas linhas chegam. Isso exige uma estrutura de índice que seja rápida de pesquisar e barata de manter atualizada.
A B-tree: páginas ordenadas, poucos níveis
Essa estrutura estava sendo desenvolvida ao mesmo tempo, e não como resposta a Codd. Ela veio de Rudolf Bayer e Edward McCreight, da Boeing Scientific Research Laboratories, que resolviam o problema geral de indexar arquivos grandes em disco. O relatório de julho de 1970 da Boeing Scientific Research Laboratories, “Organization and Maintenance of Large Ordered Indices”, descreve o problema assim:
Organization and maintenance of an index for a dynamic random access file is considered.
(tradução: Considera-se a organização e a manutenção de um índice para um arquivo dinâmico de acesso aleatório.)
Ele foi publicado depois na Acta Informatica em 1972 como Organization and Maintenance of Large Ordered Indexes, que é a citação que você costuma ver. 1972 é quando a versão revisada por pares apareceu. O relatório acima mostra que o trabalho data de 1970, o mesmo ano do artigo de Codd.
O resumo do relatório traz a propriedade principal: o esquema permite recuperar, inserir e remover chaves em tempo proporcional ao logaritmo de I na base k, onde I é o tamanho do índice e k é um número natural que depende do dispositivo. No corpo do relatório, k define a capacidade da página: toda página, exceto a raiz, guarda entre k e 2k chaves. Em termos simples, o índice é uma hierarquia de páginas, cada página guarda muitas chaves em ordem, e o número de páginas que você visita cresce apenas com o logaritmo dos dados.
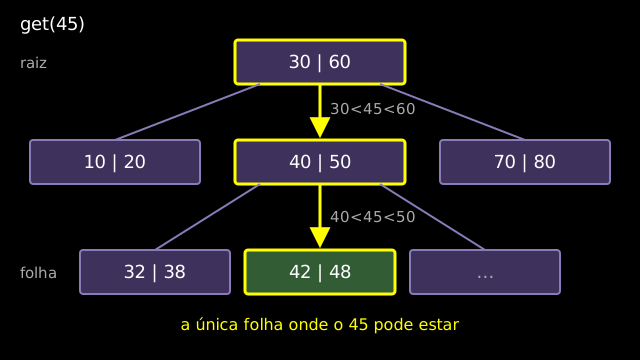
Aqui está a aritmética por trás de “três ou quatro saltos”. Se cada página guarda cerca de 100 chaves, um nível cobre 100 chaves, dois níveis cobrem cerca de 10.000, três níveis cerca de um milhão e quatro níveis cerca de cem milhões. O 100 é uma suposição para a ilustração; a capacidade real da página depende do tamanho da chave e da página. O formato da resposta não muda: uma busca toca um punhado de páginas mesmo em uma tabela enorme.
É por isso que as leituras são rápidas. As inserções mantêm os dados ordenados porque cada chave nova vai para o seu lugar na ordem, e os page splits mantêm a B-tree balanceada conforme ela cresce.
O padrão por cinquenta anos
A B-tree se encaixou tão bem no modelo relacional que virou a resposta padrão para indexação. Dá para conferir isso na documentação dos três bancos com que a maioria das pessoas começa:
- PostgreSQL:
CREATE INDEXcria índices B-tree por padrão. O capítulo sobre B-tree diz “PostgreSQL includes an implementation of the standard btree (multi-way balanced tree) index data structure.” (tradução: O PostgreSQL inclui uma implementação da estrutura de dados de índice btree padrão, uma árvore balanceada de múltiplos caminhos.) - MySQL: com exceção dos índices espaciais, os índices do InnoDB são estruturas de dados B-tree (cópia arquivada, porque o site do MySQL rejeita requisições automatizadas).
- SQLite: o formato de arquivo é construído com páginas b-tree, e o módulo B-Tree as gerencia.
Uma nuance: o PostgreSQL guarda as linhas da tabela em um heap (a documentação fala em heap-only tuples) e usa B-trees para os índices por cima, enquanto o InnoDB guarda as próprias linhas em uma B-tree, o índice clusterizado, e o SQLite guarda tabelas como table b-trees. Os três fazem update in-place das páginas da B-tree, o que os coloca do mesmo lado.
A documentação sustenta duas afirmações: a B-tree é o padrão hoje, e a estrutura tem mais de cinquenta anos.
O problema: update in-place
As B-trees pagam pela leitura rápida do lado da escrita. Para inserir ou alterar uma chave, o engine encontra a página folha dona dela, modifica essa página e a grava de volta no mesmo lugar. Se a página está cheia, ela se divide. A B-tree é atualizada onde ela vive, in-place.
Agora some os índices. Cada índice é uma estrutura própria que precisa ficar sincronizada com a tabela. A documentação do PostgreSQL diz isso diretamente: depois que um índice é criado, o sistema precisa mantê-lo sincronizado com a tabela, o que adiciona custo às operações de manipulação de dados. Com cinco índices, inserir uma linha significa guardar a linha e depois encontrar, modificar e possivelmente fazer split de uma folha em cada uma das cinco B-trees de índice. Nem toda escrita paga a conta inteira: no PostgreSQL, um update que não muda nenhuma coluna indexada pode ser um update heap-only tuple, que não precisa de novas entradas de índice. Mas todo insert toca todos os índices.
Esse preço é aceitável quando o workload é majoritariamente de leitura, ou pequeno. Não vou me aprofundar aqui de propósito: por que updates in-place são lentos em discos reais, e quanto de I/O extra elas causam, está em como funciona uma LSM tree.
A outra família
Então alguém fez uma pergunta diferente. E se as escritas nunca tocassem a B-tree diretamente? E se você as juntasse em lotes e as guardasse separadamente?
Essa pergunta leva à segunda família de storage engines, construída sobre a log-structured merge tree (LSM tree), introduzida por O’Neil, Cheng, Gawlick e O’Neil no artigo da LSM-tree de 1996. Como ela agrupa as escritas, e o que faz com elas depois, é explicado passo a passo em como funciona uma LSM tree.
Sistemas construídos sobre essa ideia incluem:
- Cassandra: a documentação do storage engine diz “The architecture is based on Log Structured Merge (LSM) trees, which utilize an append-only approach instead of the traditional relational database design with B-trees” (tradução: A arquitetura é baseada em LSM trees, que usam uma abordagem append-only em vez do projeto tradicional de banco relacional com B-trees) (documentação do Cassandra).
- RocksDB: o post de lançamento da Meta afirma que os dados são guardados na forma de uma log-structured merge tree.
- LevelDB: a biblioteca open source de banco chave-valor do Google, na qual o RocksDB se baseia (repositório).
- CockroachDB: por meio do Pebble, “an LSM key-value store” (tradução: um key-value store LSM) (Cockroach Labs). A história dessa mudança está em por que o CockroachDB trocou o RocksDB pelo Pebble.
- ScyllaDB: usa a estrutura LSM para escrever SSTables imutáveis em disco.
- TigerBeetle: sua documentação interna descreve uma coleção de LSM trees que guardam objetos e seus índices.
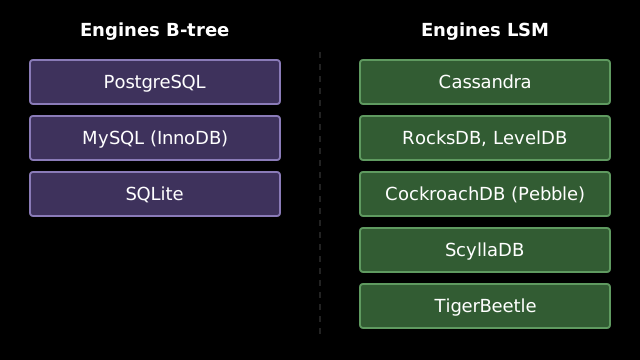
Ninguém mediu a rapidez com que esse lado está crescendo, mas o que a lista mostra é que engines com objetivos muito diferentes, de uma biblioteca chave-valor a um banco de dados de transações financeiras, escolheram a mesma família.
Por que agora
Um dos motivos para essa família estar ganhando atenção é que o armazenamento em nuvem mudou a economia de onde os dados vivem e de quanto custa reescrevê-los. Essa afirmação precisa de números e de um argumento completo, que estão em S3 e object storage para bancos de dados.
Para onde ir agora
Duas famílias, uma pergunta: para onde vão os bytes? As B-trees mantêm os dados ordenados e os atualizam in-place, o que deixa a leitura barata e a escrita cara. As LSM trees abrem mão de um pouco da simplicidade de leitura para tornar as escritas sequenciais. O próximo passo é como funciona uma LSM tree, seguido de a conjectura RUM e por que existem tantos database engines.
Fontes e leitura complementar
Fontes
- B-tree storage in the default engines: PostgreSQL B-tree, MySQL/InnoDB physical structure (cópia arquivada), SQLite B-Tree module
- Cassandra storage engine
- Under the hood: building and open-sourcing RocksDB e LevelDB
- Pebble, a RocksDB-inspired key-value store (CockroachDB), ScyllaDB compaction talk, TigerBeetle docs
- The Hollerith Machine, US Census Bureau
- IBM 305 RAMAC
- E. F. Codd, A Relational Model of Data for Large Shared Data Banks, CACM, 1970
- R. Bayer e E. McCreight, Organization and Maintenance of Large Ordered Indexes, Acta Informatica, 1972
Leitura complementar
- Bayer e McCreight, Organization and Maintenance of Large Ordered Indices, relatório da Boeing Scientific Research Laboratories, julho de 1970
- IBM: magnetic tape
- PostgreSQL: index types e introduction to indexes
- SQLite database file format
- LevelDB implementation notes
- O’Neil, Cheng, Gawlick, O’Neil, The Log-Structured Merge-Tree, 1996
- Sequential access (Wikipedia)