turbopuffer: construindo um search engine em cima do S3
Fontes (16)Assista no YouTube ↗
Conteúdo
- Quem paga pelo dado parado
- Três prateleiras, uma corrente
- Um grafo que você caminha
- Um grafo num bucket, contado
- Clusters: todos os endereços de uma vez
- O botão do recall
- A árvore do turbopuffer num bucket
- Mantendo os clusters equilibrados
- Um log no bucket
- Contando uma query fria
- Quem mantém o quê quente
- Quando escolher
- Fontes e leitura complementar
No fim de 2022, a Readwise queria busca semântica. Como o Simon Hørup Eskildsen, que estava ajudando eles, contou depois, a Readwise “pagava cerca de US$ 5 mil por mês pelo banco relacional, mas a busca vetorial nos mesmos 100 milhões e mais documentos custaria US$ 20 mil por mês ou mais”“was paying ~$5k/month for their relational database, but we found that vector search on the same 100m+ documents would’ve cost $20k/month+”. A feature foi engavetada. Os bancos vetoriais da época mantinham os índices em memória, a US$ 2 ou mais por gigabyte; um bucket custa uns dois centavos.
Por que não colocar o índice num bucket? Porque uma leitura em object storage é lenta. Eu coloquei um índice em grafo open source num bucket e contei o que uma query fria fazia: mais de mil requests, quase todos um depois do outro. O turbopuffer, o search engine que o Eskildsen acabou construindo, diz que mira no máximo três round trips no mesmo tipo de query fria. Como sair de mil para três?
Quem paga pelo dado parado
Pegue o Q&A do Notion. Uma pergunta vira um vetor, os chunks mais próximos são buscados na fatia de dados daquele workspace (um namespace), e um modelo de linguagem responde a partir deles. A página do Notion no turbopuffer lista 10B+ documentos em 10M+ namespaces, e a qualquer momento só alguns desses namespaces estão sendo consultados.
O setup antigo do Cursor, segundo o post de lançamento, mantinha “todo índice … em memória, apesar de só um subconjunto dos code-bases estar ativo em qualquer momento”“every index … in memory, despite only a subset of code-bases being active at any point in time”; sair dele cortou os custos em 95%. A memória cobra todo namespace, consultado ou não. Um bucket não.
Três prateleiras, uma corrente
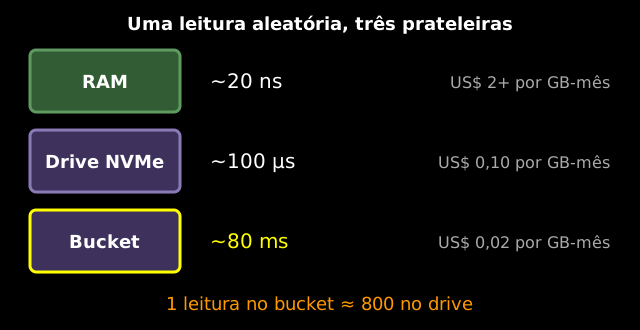
Toda leitura cai em uma de três prateleiras. Segundo a tabela de napkin math do Eskildsen, uma leitura leva cerca de 20 ns da memória, 100 µs de um drive local e 80 ms de um blob store (preços do post de lançamento). Uma leitura no bucket custa o mesmo tempo que 800 leituras no drive.
Um embedding transforma texto em centenas ou milhares de números, e pontos próximos significam textos parecidos. Checar todos os vetores funciona, mas leva cerca de dois segundos por milhão de vetores, mesmo de um SSD. Por isso a busca é aproximada, e sua qualidade é medida como recall: se 9 dos 10 primeiros aproximados estão entre os 10 primeiros exatos, o recall@10 é 90%.
Um grafo que você caminha
O índice aproximado mais conhecido é o HNSW, um grafo em camadas em que cada vetor se liga aos seus vizinhos próximos. Uma busca começa no topo, pula de forma gulosa em direção à query, desce uma camada e vagueia pela camada de baixo um vizinho por vez.
Índices em grafo de verdade raramente rodam a partir de um bucket. A biblioteca de referência, o hnswlib, aloca a camada de baixo inteira como um bloco de memória e guarda a lista de vizinhos de cada elemento ao lado do seu vetor. E a caminhada é um loop que não dá para ler adiantado: você lê a lista de vizinhos de um candidato, mede esses vizinhos e só então sabe qual lista ler em seguida. O próximo endereço está dentro da leitura que você está esperando.
Qual o tamanho da corrente? No SIFT1M, um benchmark padrão de um milhão de descritores de imagem, eu montei um índice hnswlib e contei. Com 96% de recall, uma query fez 76 leituras seguidas (cerca de 10 nas camadas de cima, 66 na de baixo) e levou 149 µs em memória. Quando um grafo passa do tamanho da memória, o DiskANN o move para um SSD, com vetores comprimidos em memória para guiar a busca.
Agora jogue a mesma corrente de 76 leituras em cada prateleira, com as latências do napkin: cerca de 8 ms num drive, cerca de 6 segundos num bucket frio. Mesmo que ler quatro blocos por rodada dividisse as rodadas por quatro, o bucket ainda levaria cerca de um segundo e meio, porque cada rodada espera a anterior. Esses 6 segundos são napkin math; as mil requests foram o que eu contei.
Um grafo num bucket, contado
O HelixDB é um banco de grafos open source com busca vetorial que de fato coloca o grafo HNSW em object storage. Ele guarda tudo como linhas num fork do SlateDB, um key-value store que vive num bucket. A lista de vizinhos de um nó é uma linha, e o vetor dele é outra, arquivada na ordem de um fingerprint SimHash para que vetores parecidos dividam um bloco. O fingerprint vem do paper LSM-VEC; a ordenação é o layout do HelixDB.
Rodei nos primeiros 100.000 vetores do SIFT, numa máquina com os arquivos em disco local, e contei os requests à camada de storage num nó recém-iniciado. Isso é pessimista para uma query fria, já que as camadas de cima também são lidas pelo SlateDB. Uma query fez 367 requests em média, para 71% de recall. Chegar a 97% custou 1.086, e nunca mais de três estavam em voo ao mesmo tempo.
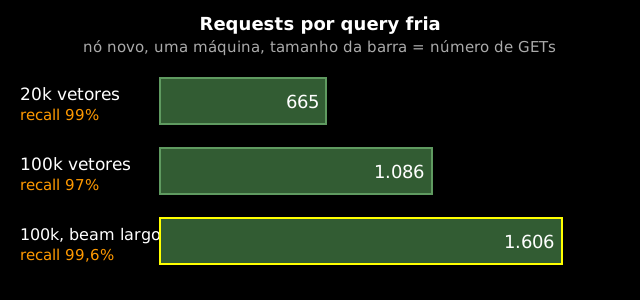
Um passo também não é um request só: ele lê uma linha de vizinhos, fingerprints e vetores de blocos diferentes de arquivos diferentes, e num nó novo cada bloco é um request. Com 20 ms injetados por request, uma query fria levou 24 segundos (média de 10 queries, 1.138 requests), a menos de 6% do valor de requests vezes atraso: cada request esperou o anterior. E a corrente cresce com o índice: cinco vezes mais vetores levaram 60% mais requests com a mesma configuração e perderam dois pontos de recall; manter o recall em 99% levou 2,4 vezes mais.
O grafo em si está bem: com tudo num cache em memória, a mesma query levou 29 ms e não fez nenhum request. O que mata são as leituras frias. O commit message do próprio HelixDB diz o mesmo: com caches só em memória, um índice de 100K vetores no S3 sofria thrashing no block cache e “cada hop do HNSW virava um GET serial no S3”“Every HNSW hop became a serial S3 GET”. A resposta foi trocar a prateleira: o servidor agora sempre mantém um cache em disco local na frente do bucket, de 8 GiB por padrão.
Isso são formas de uma máquina com latência injetada, não S3 de verdade e nem um benchmark de produto.
Clusters: todos os endereços de uma vez
Recomece. Agrupe os vetores em clusters e dê a cada cluster um centroid que o representa. Uma busca compara a query com os centroids, escolhe os mais próximos, busca só esses clusters e confere cada vetor lá dentro. Esse é o design do SPANN, e ele muda a estrutura de dependência: depois de ler os centroids, você conhece o endereço de todo cluster de que precisa, então todas essas leituras saem juntas.
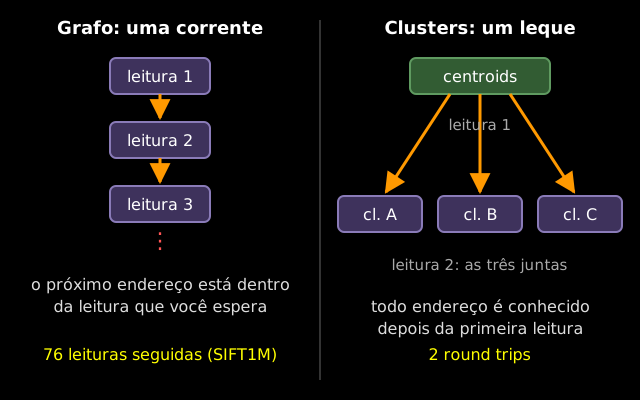
Num bucket, a latência é definida principalmente por round trips, não por bytes. O post do turbopuffer sobre o design de filtros põe o contraste nas próprias palavras: uma busca por clusters totalmente fria precisa de no máximo dois round trips, ao contrário de “estruturas de ANN baseadas em grafo, que facilmente exigiriam uma dúzia ou mais de round trips”“graph-based ANN structures that would easily require a dozen or more roundtrips”.
O botão do recall
O porém: cada cluster que você pula pode custar respostas certas. Dividi os vetores do SIFT1M em 10.000 clusters de uns cem e medi o recall contra o número de clusters abertos.
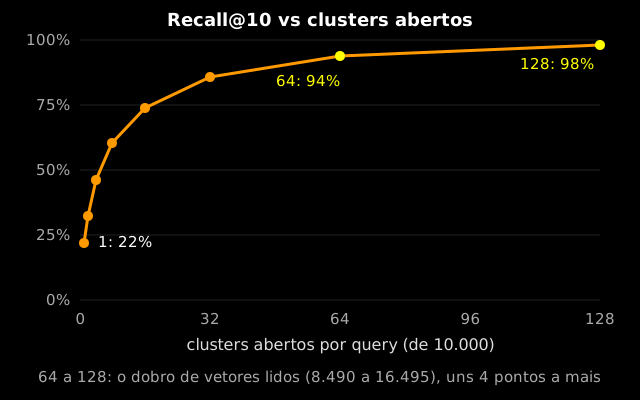
Abrir um cluster acha 22% dos 10 primeiros verdadeiros, 32 acham 86%, 64 acham 94%. Os bytes lidos crescem em linha reta, mas o recall achata: de 64 para 128 clusters os vetores lidos dobram (8.490 para 16.495) por uns quatro pontos a mais. As respostas que faltam ficam perto das bordas dos clusters, então o SPANN guarda alguns vetores de borda em vários clusters, pagando espaço por recall.
A árvore do turbopuffer num bucket
O turbopuffer é closed source, então daqui em diante é o relato dele mesmo. Sua documentação de arquitetura diz que seus índices vetoriais são baseados no SPFresh, um índice de centroids. Cada namespace é um prefixo num bucket que guarda um write-ahead log e os arquivos do índice: um arquivo de centroids e arquivos grandes de clusters. O segundo trip ao índice de uma query pede só os byte ranges dos clusters que ela escolheu.
Com cem bilhões de vetores até a lista de centroids é enorme, então o post do ANN v3 agrupa os centroids também, com cerca de 100 filhos por nó. Nas palavras dele, “a hierarquia limita o número de round trips ao object storage à altura da árvore SPFresh”“the hierarchy bounds the number of round-trips to object storage to the height of the SPFresh tree”. Os níveis de cima, pequenos, ficam em memória, e uma cópia de um bit de cada vetor deixa a primeira passada barata, com menos de 1% rechecado em precisão total. Nesse tamanho o post diz que cada máquina busca cerca de 500 clusters de 100 vetores para bater a meta de recall, com a árvore inteira em SSD local.
Ele também se checa sozinho: segundo o post de continuous recall, 1% das queries ao vivo são reexecutadas de forma exaustiva e comparadas, contra uma meta de 90 a 95% de recall@10.
Mantendo os clusters equilibrados
Vetores novos entram no cluster mais próximo, e os dados não chegam de forma uniforme. Um cluster gordo deixa lenta toda query que o abre, e mesmo recém-saído do meu build os tamanhos eram desiguais: mediana 93, maior 697. O conserto usual é reconstruir tudo. O paper do SPFresh precifica isso para um grafo DiskANN de um bilhão de vetores em “um pico de uso de memória de 1100GB por 2 dias”“a peak memory usage of 1100GB for 2 days”, e nota que o Vearch reconstrói toda semana.
Se você conhece LSM trees, já viu essa escolha. Uma reconstrução global é uma compaction completa: reescrever tudo para consertar uma parte pequena. O SPFresh faz a compaction pequena, três movimentos locais: split de um cluster que passa de um limite de tamanho em dois, cada um com um centroid novo; reassign dos vetores perto do split para o centroid que agora estiver mais próximo, checando só clusters vizinhos; merge de um cluster que encolhe abaixo de um limite inferior com o vizinho mais próximo. O paper mostra que uma cascata de splits e reassigns sempre termina. No teste dele com 100M de vetores, precisou de cerca de 10 GB e 2 cores onde uma reconstrução de um bilhão de vetores precisa de cerca de mil gigabytes extras e 32 cores, e sua tail latency foi 2,41 vezes menor que a do DiskANN.
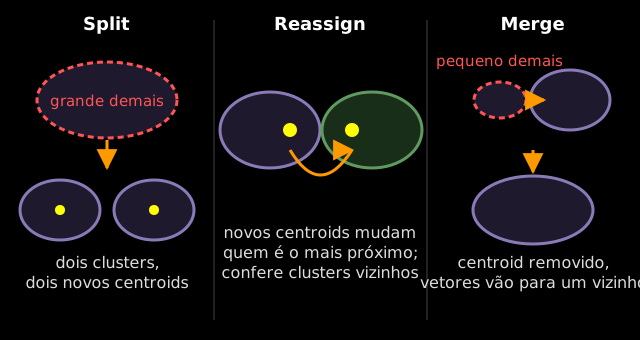
A primeira versão do turbopuffer reconstruía o índice quando o log ficava muito à frente; como o Eskildsen diz na palestra do CMU, “a gente reconstruía o mundo inteiro”“we rebuilt the entire world”. A segunda roda uma versão própria e fechada do SPFresh em nós indexadores separados.
O HelixDB, na versão que eu medi, repara o grafo dentro da escrita: um insert começa com uma busca de 200 candidatos de largura e depois reescreve até 32 listas de vizinhos na mesma transação. Montar meus 100.000 vetores levou quase duas horas. Os primeiros 10.000 levaram 39 segundos enquanto tudo cabia em memória; os últimos 10.000 levaram 18,4 minutos, cerca de 9 vetores por segundo. Um pull request mergeado em 5 de outubro de 2026, depois da versão que eu medi, move o trabalho de índice para um indexador em background, e buscas fortemente consistentes também checam a fila.
Um log no bucket
As escritas do turbopuffer pulam o índice por completo. Segundo a documentação de arquitetura, toda escrita adiciona um arquivo a um log no prefixo do namespace, com no máximo uma entrada por segundo por namespace e escritas concorrentes em lote, e o cliente só recebe OK quando o objeto está no bucket (p50 de 165 ms para 500 kB). A doc marca um ponto de commit por compare-and-swap e um cursor do índice que mostra até onde o índice alcançou; na mesma palestra, o Eskildsen diz que os arquivos de log são commitados num manifest com esse compare-and-swap.
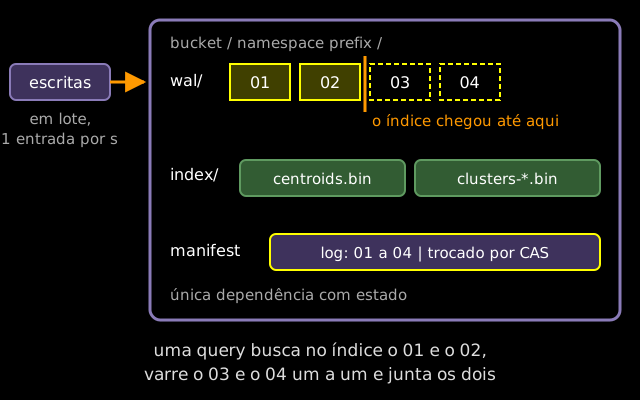
Antes de responder, uma query pergunta ao bucket se o manifest mudou: uma leitura condicional de cerca de 10 ms que define um piso de latência para leituras consistentes. Consistência eventual pula isso. O dado ainda não indexado é buscado de forma exaustiva no log e juntado com o que o índice achou. Esse é o caminho de leitura de uma MemTable mais sorted runs, com a parte recente guardada no bucket. Quando mais de 128 MiB esperam para ser indexados, novas escritas esperam antes de aparecer.
Por baixo, diz o Eskildsen na palestra, os índices são pares key-value numa LSM com a tiered compaction mais simples que você consegue imaginar, rodada pelos nós indexadores.
Em setembro de 2026 o turbopuffer anunciou uma v3 que deixa de indexar tudo pelo endereço de cluster do vetor, porque dividir um cluster então move o documento e toda entrada de índice que aponta para ele: “Atualizar um único vetor pode mover centenas de atributos e seus índices.”“Updating just one vector can move hundreds of attributes and their indexes.” O índice vetorial passa a ser um índice secundário entre outros. Em novembro de 2026, o benchmark noturno dele mostra a v3 mais rápida que a produção na maioria das queries (p90 de full-text quente 20 ms contra 38, vetorial quente 21 contra 41), com só algumas queries de count quente um pouco mais lentas. Ela ainda não está em produção, e a nota de rodapé da página diz “não esperamos que a v3 reduza de forma significativa a latência de queries vetoriais frias”“we do not expect v3 to significantly reduce latency for cold vector queries”.
Contando uma query fria
Uma query fria, como a doc descreve: um trip para os metadados do namespace, um para o índice de filtro, os centroids e o log ainda não indexado em paralelo, e um para os clusters. Índices grandes podem precisar de um quarto.
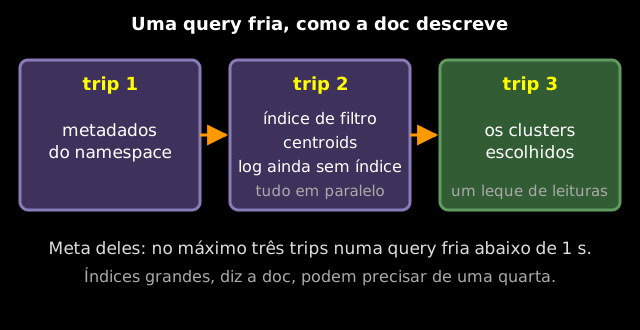
Três é uma regra de design, não um resultado: o post de lançamento diz “a gente mira limitar a no máximo três round trips para uma latência fria abaixo de um segundo”“we aim to limit it to a maximum of three roundtrips for sub-second cold latency”, e o planner troca um trip extra por buscar mais bytes num trip que já está fazendo. A doc chama os 3 a 4 trips de “tão pouco quanto ~400ms”“as little as ~400ms” e dá medianas para 1M de documentos: 874 ms frio e 14 ms quente.
Ao lado da minha contagem de 1.086 requests dependentes num nó HelixDB novo, isso não é um ranking: um é a minha medição, os outros são a meta e a mediana do turbopuffer. O que têm em comum é o formato: um grafo paga por uma corrente de leituras dependentes, uma árvore de clusters paga pela sua altura.
Quem mantém o quê quente
Resta saber quanto manter quente. No turbopuffer, os nós de query são caches em memória e em NVMe, e só o bucket guarda estado, então qualquer nó pode servir qualquer namespace e um nó morto custa só o seu cache. Queries frias acontecem quando um namespace ficou parado por horas ou seu nó morreu.
O Amazon S3 Vectors promete menos de um segundo para queries infrequentes e cerca de 100 ms ou menos para as frequentes. O Notion esconde a query fria: abrir um diálogo que pode fazer busca dispara uma query de prewarm para aquele namespace, que é grátis se ele já está quente. Você também pode pagar para fixar um namespace em drives reservados, cobrado por hora, com break-even perto de 10 queries por segundo. No extremo, o CobbleDB da Perplexity nunca esfria: para as páginas que a Perplexity escolhe servir, o hot store guarda os trechos e seus embeddings em NVMe, em três réplicas.
Quando escolher
Pelo relato dele mesmo, o turbopuffer serve para first-stage retrieval, em que você reduz milhões de documentos a poucos candidatos para o seu código reranquear, com muitos namespaces que ficam quase sempre parados e escritas que podem esperar. Pule se toda leitura precisa ser consistente em menos de 10 ms (consistência eventual é a saída), se você precisa de transações, ou se precisa ser open source e rodar por conta própria.
Fontes e leitura complementar
Fontes
- turbopuffer: fast search on object storage, Simon Hørup Eskildsen, atualizado em 5 de março de 2026: Readwise, Cursor, a meta de três round trips.
- turbopuffer architecture: WAL, manifest, índice baseado em SPFresh, medianas frio e quente.
- turbopuffer guarantees, tradeoffs e limits: bucket como único estado, sem transações gerais, limite de 128 MiB, piso de 10 ms, horas em cache, quando escolher.
- Notion on turbopuffer: 10B+ documentos, 10M+ namespaces, prewarm.
- ANN v3: 100 billion vectors: árvore de centroids, round trips limitados pela altura.
- Native filtering: no máximo dois round trips contra uma dúzia para grafos.
- Continuous recall: tempo da busca exaustiva, recall@k, amostragem de 1%.
- RIP, vector database e a página da v3: a v3 e seu benchmark noturno, em novembro de 2026.
- Docs de warm cache e pinning.
- napkin-math: a tabela de latências.
- hnswlib e o paper do HNSW.
- DiskANN, NeurIPS 2019.
- SPANN, NeurIPS 2021 e SPFresh, SOSP 2023.
- LSM-VEC e HelixDB, o commit do disk cache e o PR #1156.
- CMU Database Group talk by Simon Hørup Eskildsen: as reconstruções da primeira versão, a LSM por baixo.
- Amazon S3 Vectors GA e Perplexity CobbleDB.
As minhas medições (hnswlib no SIFT1M, clusters planos no SIFT1M, HelixDB nos primeiros 100.000 vetores do SIFT) rodaram numa máquina só, e os números do HelixDB usam um filesystem local com 20 ms injetados por request.
Leitura complementar
- SlateDB: what if S3 were your only disk para o key-value store nativo de bucket em que o HelixDB se apoia.
- S3 and object storage for databases para o modelo de preço e de requests por trás das prateleiras.