A guerra de compaction do Cassandra
Fontes (19)Assista no YouTube ↗
Conteúdo
- Três contas em um nó
- Size-tiered: escrita barata, disco em dobro
- Quando o espaço não existe
- Leveled: merges pequenos, muitas reescritas
- Uma regra, duas esperas
- Colocando preço nas duas pontas
- Por que a leveled fica para trás, e o que o UCS faz
- Densidade e shards cortam a conta de disco
- Um delete é uma escrita
- Zumbis e gc_grace_seconds
- Janelas de tempo: apagando arquivos inteiros
- Vale escolher o Cassandra em 2026?
- Escolhendo a configuração de compaction
- Fontes e leitura complementar
No começo de 2022, o Discord guardava suas mensagens no Cassandra: 177 nós com trilhões de mensagens e, nas palavras deles, “um sistema de muito trabalho braçal”“a high-toil system”. O problema que sempre voltava era a compaction:
A gente vivia ficando para trás nas compactions, em que o Cassandra compacta SSTables no disco para ter leituras mais rápidas. Não só as nossas leituras ficavam mais caras, como a gente via latência em cascata enquanto um nó tentava compactar.
We were prone to falling behind on compactions, where Cassandra would compact SSTables on disk for more performant reads. Not only were our reads then more expensive, but we’d also see cascading latency as a node tried to compact.
A gambiarra tinha nome: a gossip dance. Eles iam “tirar um nó de rotação para deixá-lo compactar sem receber tráfego, trazê-lo de volta para pegar os hints do hinted handoff do Cassandra e repetir até o backlog de compaction zerar.”“take a node out of rotation to let it compact without taking traffic, bring it back in to pick up hints from Cassandra’s hinted handoff, and then repeat until the compaction backlog was empty.”
Um banco que precisa sair de serviço para arrumar os próprios arquivos está pagando uma conta em algum lugar. Ao longo dos anos, o Cassandra lançou cinco estratégias de compaction, e cada uma é uma aposta sobre qual conta dói menos.
Três contas em um nó
O Cassandra combina a replicação do Dynamo, da Amazon, com o modelo de storage do Bigtable, do Google: a chave de cada linha passa por um hash e cai num anel de nós, cada linha vive em várias réplicas (três, no caso do Discord), e cada nó roda a sua própria LSM tree. As escritas entram numa tabela em memória, viram arquivos ordenados e imutáveis no disco, as SSTables, e um processo em background, a compaction, faz o merge desses arquivos. Cada nó compacta sozinho.
A compaction existe para trocar um custo por outro. A RUM conjecture diz que dá para baixar dois entre custo de leitura, custo de escrita e custo de espaço, nunca os três. Em um nó só, esses três custos viram três coisas que dá para observar:
- Arquivos por leitura: quantas SSTables um lookup pode ter que checar.
- Reescritas por byte: quantas vezes a compaction copia o mesmo dado.
- Disco: o espaço que os arquivos ocupam, mais o espaço que um merge precisa enquanto roda.
O problema do Discord era o primeiro. Quando a compaction fica para trás, os arquivos do flush se acumulam e cada leitura precisa cavar mais fundo.
Existem duas formas clássicas de fazer esse trabalho. A compaction tiered é uma mesa bagunçada: você deixa pilhas de tamanho parecido crescerem e depois faz o merge. Poucas reescritas, mas uma leitura tem que olhar cada pilha. A compaction leveled é uma estante: uma leitura olha um arquivo por nível, mas você vive reescrevendo para manter tudo arrumado.
Size-tiered: escrita barata, disco em dobro
O Cassandra começou na mesa. A estratégia size-tiered espera por “um número definido (padrão: 4) de SSTables de tamanho parecido”“a set number (default: 4) of similar-sized SSTables” e faz o merge delas em uma só. O Jonathan Ellis a descreveu em 2011 como “muito parecida com a descrita no paper do Bigtable, do Google”“very similar to the one described in Google’s Bigtable paper”, e ela ainda é o que uma tabela recebe quando não pede nada.
Acompanhe um nó enchendo. Quatro arquivos pequenos viram um médio, quatro médios viram um grande. Em 2017, o Discord tinha quase 1 TB de dados comprimidos em cada nó; num nó assim, a pilha do topo acaba com arquivos de umas duas centenas de gigabytes cada.
Quando esses quatro entram em merge, a saída é escrita como um arquivo novo, e as entradas não podem ser apagadas até ela terminar. As leituras ainda são servidas por elas, e se o nó cair no meio do caminho, nada pode se perder. Durante esse merge, o nó guarda os mesmos dados duas vezes.
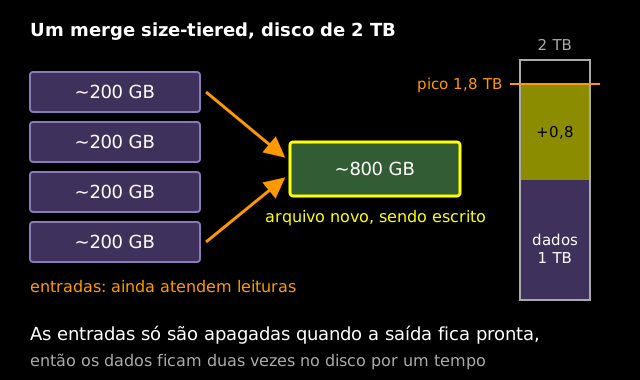
A documentação do STCS admite: “o espaço em disco necessário para as SSTables novas e antigas ao mesmo tempo durante a compaction STCS pode ultrapassar o espaço em disco típico de um nó.”“the amount of disk space needed for both the new and old SSTables simultaneously during STCS compaction can outstrip a typical amount of disk space on a node.” As release notes da versão 1.0 colocam um número no pior caso: 50% do disco livre. Um terabyte de dados pede um disco de dois terabytes.
Isso não é o space amplification em repouso, em que versões antigas de uma chave esperam nos níveis de cima até a compaction chegar nelas. Esse é temporário: só existe enquanto um merge roda, e é do tamanho do próprio merge.
Quando o espaço não existe
Antes de cada compaction, o Cassandra estima o tamanho da saída. Se não couber, ele loga “espaço insuficiente para compactar todos os arquivos pedidos”“insufficient space to compact all requested files”, tira a maior entrada e tenta de novo. Se nada couber, a compaction é abortada com “espaço insuficiente para a compaction”“Not enough space for compaction”.
Repare em qual arquivo fica de fora: o maior, que guarda os dados mais antigos. Os valores sobrescritos e os deletes dentro dele continuam no disco, e toda leitura continua olhando para ele. A conta de disco vira conta de leitura.
Leveled: merges pequenos, muitas reescritas
A solução para a conta de disco chegou com o Cassandra 1.0, em outubro de 2011: a compaction leveled, “baseada no LevelDB, do time do Chromium no Google”“based on LevelDB from the Chromium team at Google”, como disse o Ellis. As mesmas release notes dizem que com ela “você só precisa manter alguns MB livres para a compaction em vez de (no pior caso) 50%.”“you only need to keep a few MB of space free for compaction instead of (in the worst case) 50%.”
Cada nível é dez vezes maior que o de baixo, e os arquivos são pequenos: 160 MiB por padrão. Uma compaction faz o merge de um arquivo com os dez ou tantos que ele sobrepõe no nível seguinte, então mexe em uns 11 × 160 MiB, menos de 2 GB. A documentação do LCS lista o preço: ela usa mais IO e CPU, e é uma escolha ruim para tabelas com muita escrita. A leveled paga em reescritas.
Então a size-tiered pagava em disco e a leveled em reescritas, e mudar de ideia era caro. A documentação do UCS lembra que STCS, LCS e TWCS “vão exigir uma compaction completa dos dados se a estratégia de compaction mudar”“will require full compaction of the data if the compaction strategy is changed”.
Uma regra, duas esperas
O Cassandra 5.0, anunciado em 5 de setembro de 2024, trouxe a Unified Compaction Strategy. O Branimir Lambov a propôs como CEP-26, e a documentação faz uma afirmação ousada:
Não é preciso usar as estratégias de compaction legadas, porque o UCS pode ser configurado para se comportar como qualquer uma delas.
There is no need to use legacy compaction strategies, because UCS can be configured to behave like any of them.
A ideia começa com uma observação do design doc. As duas formas constroem níveis que crescem por um fator fixo, o fanout: quatro na mesa, dez na estante. E as duas fazem merge pelo mesmo motivo. Arquivos que cobrem as mesmas chaves se empilham, e cada arquivo da pilha é mais um para a leitura checar. Então cada nível espera até a pilha ficar alta demais, e aí faz o merge.
A única discordância é sobre quão alta.
- A tiered espera por quatro. Quatro arquivos se acumulam e viram um quatro vezes maior, um nível acima. Cada byte é copiado mais ou menos uma vez por nível, mas uma leitura olha cada arquivo que ainda está esperando.
- A leveled faz merge com dois. Assim que um segundo arquivo chega num nível, ele entra em merge com o que já estava lá. Uma leitura olha um arquivo por nível, mas esse arquivo é reescrito de novo e de novo, até ficar dez vezes maior e subir.
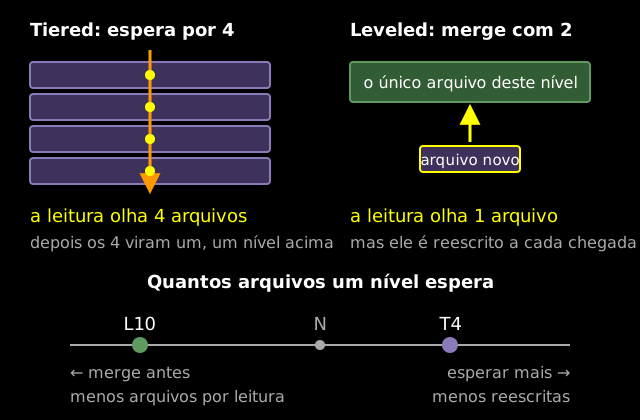
Esperar mais economiza reescritas; fazer merge antes economiza leituras. Pesquisadores desenharam essa linha primeiro. Numa palestra na Microsoft Research, o Niv Dayan, então em Harvard, colocou os key-value stores em “um contínuo de trade-offs, em que nos extremos temos o log e o array ordenado”“a trade-off continuum, where at the extremes, we have the log and the sorted array”, com o ponto “em que os designs tiered e leveled convergem”“where the tiered and the leveled designs converge” num size ratio de dois. Nunca espere e você se aproxima de um array ordenado; espere para sempre e você tem um log. A versão em paper é o Dostoevsky.
O UCS escreve a posição nessa linha como uma letra e um número. A letra é a forma, T para tiered e L para leveled; o número é o fanout. A documentação mapeia as estratégias antigas nela: T4 é a size-tiered, esperando por quatro; L10 é a leveled, crescendo de dez em dez. T4 é o padrão.
Colocando preço nas duas pontas
O design doc dá proporções, não números exatos: o write amplification cresce com o número de níveis na tiered, e com o fanout menos um vezes os níveis na leveled; o read amplification vai no sentido contrário. Com números nossos para um nó (ilustrativos, não medidos): 1 TB de dados, flushes de uns 100 MB, ou seja, crescimento de 10.000× da base ao topo.
| Configuração | Níveis | Reescritas por byte | Arquivos por leitura |
|---|---|---|---|
| T4 | log₄ 10.000 ≈ 7 | uma por nível ≈ 7 | até 3 esperando por nível ≈ 20 |
| L10 | log₁₀ 10.000 = 4 | até 9 por nível, ≤ 36 | um por nível = 4 |
Por que a leveled fica para trás, e o que o UCS faz
A leveled tem um ponto fraco sob muita escrita. Um arquivo novo no nível 0 não pode entrar em merge com o nível 1 enquanto os arquivos do nível 1 que ele sobrepõe estão ocupados em outra compaction, então o nível 0 se acumula. O próprio código do Cassandra admite num comentário: escolher o nível com o maior score “desmorona de forma espetacular quando você fica para trás.”“falls apart spectacularly once you get behind.”
O UCS escolhe o próximo merge pela conta de leitura. Segundo o design doc, quando está atrasado, “escolhemos o bucket de compaction com a maior sobreposição”“we select a compaction bucket whose overlap is the highest”, em qualquer nível que a pilha esteja, o que evita a falha que o próprio documento descreve: “todos os recursos consumidos pelo L0 e SSTables se acumulando no L1”“all resources consumed by L0 and sstables accumulating on L1”. A documentação também diz o que mexer quando uma tabela não acompanha as escritas: mover a configuração na direção de T, que reescreve menos. Dá até para ter uma configuração por nível: tiered embaixo, onde chegam as rajadas de escrita, e leveled em cima, para leituras rápidas.
O Discord nunca chegou a usar nada disso. Eles trocaram o banco de mensagens em maio de 2022, mais de dois anos antes do UCS sair.
Densidade e shards cortam a conta de disco
Leitura contra reescrita é um trade-off. A conta de disco da mesa é outro, e o UCS a corta dividindo os arquivos em pedaços menores. Isso cria um problema: um pedaço pequeno de um nível enorme fica igualzinho a um flush recém-chegado se você julgar só pelo tamanho.
A solução é a densidade: o tamanho de um arquivo dividido pela fração do token range do nó que ele cobre. Um arquivo de 1 GB que cobre um quarto do range tem densidade de 4 GB, então ele pertence ao mesmo nível que um arquivo de 4 GB cobrindo tudo.
Com os níveis medidos por densidade, o UCS pode cortar cada arquivo em fronteiras fixas ao longo do range de chaves do nó. A documentação chama essas fatias de shards, mas nada se move entre máquinas: é só onde um nó corta os próprios arquivos. Segundo o design doc, as fronteiras são potências de dois, então níveis maiores ganham mais fronteiras, nunca fronteiras diferentes. Como todo nível é cortado nas mesmas linhas, nenhum merge cruza uma delas, as fatias compactam lado a lado, e cada merge só precisa de espaço livre para a própria fatia.
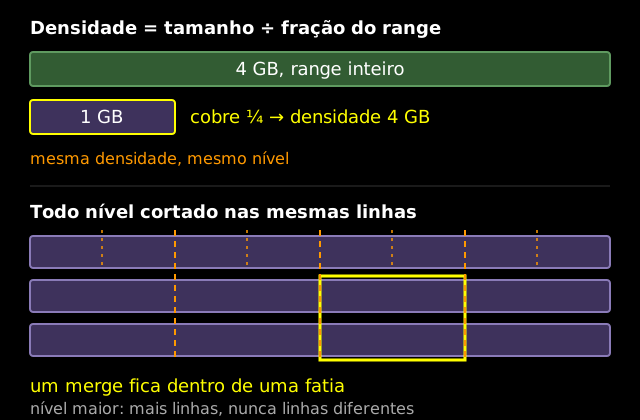
Até uma compaction completa roda fatia por fatia: o design doc diz que ela se divide em mais ou menos um job por shard, “reduzindo o overhead de espaço por um fator próximo de”“reducing the space overhead by a factor close to” o número de shards. A exceção é quando nós entram ou saem do anel: as fronteiras mudam, e uma compaction completa volta a precisar de uma cópia inteira.
A densidade também deixa mudar a forma com a tabela rodando. A documentação diz que uma mudança de parâmetro “só dispara as compactions necessárias”“only initiates compactions that are necessary” para chegar à forma nova; nada é reescrito do zero.
Um delete é uma escrita
Todas as contas até aqui eram de dados que você queria manter. Deletes também custam, porque numa LSM tree um delete é uma escrita: o Cassandra insere “um marcador de deleção com timestamp chamado tombstone”“a time-stamped deletion marker called a tombstone”, e o valor que ele esconde fica no disco até a compaction juntar os dois.
Em 2017, o Discord rodava em doze nós. Cada mensagem era uma linha numa partição com chave formada pelo canal e um bucket de dez dias, PRIMARY KEY ((channel_id, bucket), message_id). O post daquele ano conta duas surpresas:
Apagar uma coluna e escrever null numa coluna são exatamente a mesma coisa. As duas geram uma tombstone.
Deleting a column and writing null to a column are the exact same thing. They both generate a tombstone.
O schema tinha 16 colunas e a mensagem média preenchia 4, então cada mensagem gravava 12 tombstones. Uns seis meses depois, o canal de um servidor público levava 20 segundos para carregar. Ele tinha exatamente uma mensagem; o servidor tinha apagado milhões delas pela API, e toda leitura atravessava as tombstones.
É a conta de leitura de novo, paga em linhas mortas (o mesmo custo que os scans pagam em qualquer LSM). O Cassandra tem alarmes para isso: um aviso com 1.000 tombstones numa query, e com 100.000 ele aborta a query.
Zumbis e gc_grace_seconds
Por que não descartar as tombstones antes? Numa máquina só a regra é simples: uma tombstone pode ir embora quando não sobra nada mais antigo embaixo dela. A compaction do Cassandra checa exatamente isso, e acrescenta uma segunda condição, porque um nó não é o banco inteiro.
Quando um nó fica em silêncio, os outros não conseguem saber se ele morreu ou só está lento; cada um decide sozinho, pelos heartbeats. Qualquer réplica aceita um delete sozinha, mas esquecer esse delete com segurança exige todas as réplicas, inclusive a atrasada.
É assim que dá errado. Uma linha com valor A vive em três réplicas. Um delete chega em duas enquanto a terceira está fora. O coordenador guarda um hint para a réplica que falta, mas só se ela estiver fora há menos que a janela de hints, três horas por padrão. Passado isso, só um repair entrega a tombstone. Dias depois, as duas réplicas vivas compactam e descartam a tombstone junto com o valor. Aí a terceira volta, ainda com A. O repair vê um valor num nó e nada nos outros, e copia A de volta para todo mundo.
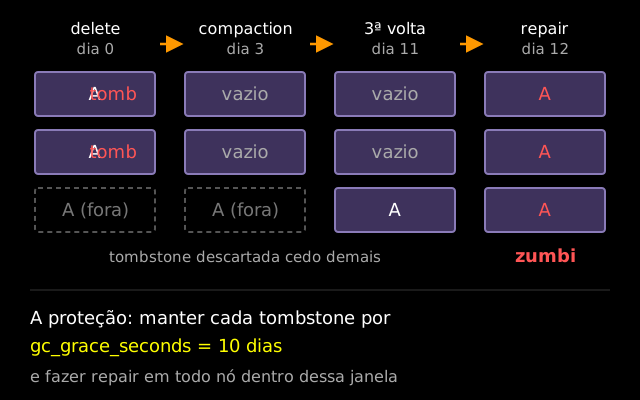
A documentação de tombstones chama o resultado de zumbi. A proteção é um período de carência: a compaction não descarta uma tombstone antes de ela ficar mais velha que gc_grace_seconds, 864.000 segundos (dez dias) por padrão, mesmo quando não sobra nada mais antigo embaixo. A documentação de repair transforma isso em agenda: “Com o gc grace padrão de 10 dias, fazer repair em todos os nós do cluster pelo menos uma vez a cada 7 dias evita isso”“With a default gc grace period of 10 days, repairing every node in your cluster at least once every 7 days will prevent this”.
O Discord cortou a folga: “Baixamos o tempo de vida das tombstones de 10 dias para 2 dias porque rodamos repairs do Cassandra (um processo anti-entropia) toda noite no nosso cluster de mensagens.”“We lowered the lifespan of tombstones from 10 days down to 2 days because we run Cassandra repairs (an anti-entropy process) every night on our message cluster.” Menos dias de tombstones é menos lixo para cada leitura atravessar. Mas um grace curto só é seguro enquanto o repair continua rodando dentro dele, e garantir isso é trabalho do operador. O Cassandra 6.0, ainda em alpha, traz um agendador de repair embutido, desligado por padrão, e a documentação dele repete a regra: “tente rodar repairs num intervalo menor que gc_grace_seconds para evitar a ressurreição de dados”“attempt to run repairs at a smaller interval than gc_grace_seconds to avoid data resurrection”.
Essa é a conta que nenhuma configuração de compaction corta. T4 ou L10 decide quando os arquivos entram em merge; quando uma tombstone pode sair quem decide são as outras réplicas e o repair.
O Discord recebeu essa conta no final. Em 2022, copiando tudo para fora do Cassandra, a migração “travou em 99,9999% (sério)”“got stuck at 99.9999% complete (no, really)”. Os últimos token ranges tinham “ranges gigantescos de tombstones que nunca tinham sido eliminados pela compaction no Cassandra.”“gigantic ranges of tombstones that were never compacted away in Cassandra.” Eles compactaram esse range, “e segundos depois a migração estava completa!”“and seconds later, the migration is complete!”
Janelas de tempo: apagando arquivos inteiros
Alguns dados nem esperam um delete: são gravados com prazo de validade. Métricas, logs e leituras de sensores são escritos uma vez, em ordem de tempo, e guardados por um período fixo: 90 dias no exemplo da documentação do TWCS. Quando o TTL de um valor acaba, ele é tratado como tombstone e espera o período de carência como qualquer outra.
Na mesa size-tiered, os arquivos são agrupados por tamanho, não por idade, então um arquivo resultante de merge mistura leituras do trimestre passado com as de hoje de manhã. Ele não pode ser jogado fora até tudo dentro dele expirar, e até lá a compaction continua reescrevendo esse arquivo.
A primeira resposta do Cassandra para séries temporais, a compaction date-tiered, veio de uma dissertação de mestrado no Spotify, em 2014. The Last Pickle a achou “muito difícil de entender”“very hard to reason about”, e ela foi removida na 5.0. Em 2015, o Jeff Jirsa, então na CrowdStrike, propôs uma alternativa, e como dizia o primeiro slide da palestra dele no Cassandra Summit 2016, ele fez isso “porque todo o resto o deixava triste”“because everything else made him sad”.
A estratégia time-window dele agrupa arquivos por tempo em vez de tamanho. Cada arquivo vai para a janela da sua escrita mais recente. Dentro da janela atual, os arquivos continuam em merge size-tiered; quando a janela fecha, seus arquivos são compactados em um só, e aí ficam quietos.
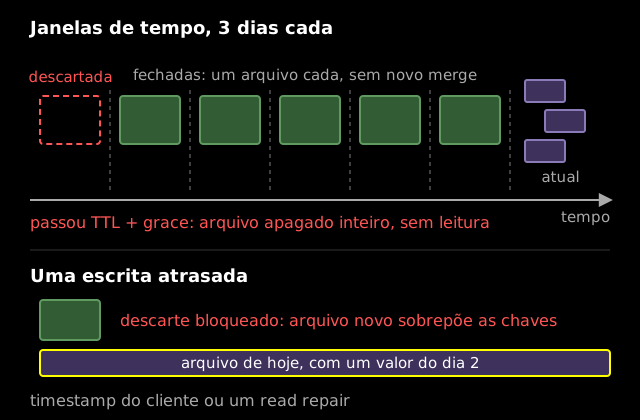
Quando os dados da janela mais antiga passaram do TTL e do período de carência, e nenhum outro arquivo tem dados mais antigos para as mesmas chaves, o Cassandra descarta a SSTable inteira sem lê-la. É o mesmo truque das delete-only compactions do Pebble: quando um arquivo inteiro está morto, apague o arquivo, não as chaves dentro dele. Sem leitura, sem reescrita, e o disco volta na hora.
A documentação sugere mirar em “aproximadamente 20 a 30 janelas”“approximately 20-30 windows”: com TTL de 90 dias, janelas de 3 dias. Você fica com uns trinta arquivos, mais alguns pelo período de carência, e a cada três dias um chega e um sai.
O porém é a ordem. Se um valor antigo é escrito hoje, com timestamp definido pelo cliente ou puxado para a MemTable por um read repair, ele cai no arquivo de hoje. Esse arquivo passa a sobrepor as janelas antigas e segura o descarte delas. Existe uma opção, unsafe_aggressive_sstable_expiration, que pula essa checagem, e a documentação avisa que ela “pode levar a perda de dados ou a dados apagados reaparecendo”“can lead to data loss or deleted data re-appearing”: o zumbi de novo.
O UCS cobre esse caso também. Dentro de um nível, o design doc diz que ele agrupa arquivos por timestamp, enquanto a size-tiered “perde a ordem temporal com facilidade”“easily loses time order”, e para séries temporais a documentação sugere T8 com uma checagem de arquivos expirados a cada 300 segundos.
Vale escolher o Cassandra em 2026?
Muita gente escolhe. A Netflix escreveu em 2024 que “o Cassandra é a espinha dorsal de uma variedade de casos de uso dentro da Netflix”“Cassandra serves as the backbone for a diverse array of use cases within Netflix”, de cadastros a histórico de visualização. A Bloomberg aparece na página do projeto servindo “mais de 20 bilhões de requisições por dia sobre um dataset de quase 1 PB, numa frota de mais de 1.700 nós Cassandra.”“more than 20 billion requests per day on a nearly 1 PB dataset across a fleet of 1,700+ Cassandra nodes.”
Ele faz sentido quando as escritas nunca param, quando os dados precisam ficar de pé em vários data centers sem um líder único para fazer failover, e quando você conhece suas queries antes de desenhar as tabelas; a documentação diz com todas as letras: “No Cassandra, a modelagem de dados é guiada pelas queries.”“In Cassandra, data modeling is query-driven.” Não faz sentido quando seus dados cabem num Postgres grande. O Cassandra não tem joins, e transações entre partições (Accord) só chegam na 6.0, ainda em alpha. Se você quer o modelo sem operar o cluster, serviços gerenciados como o Amazon Keyspaces falam a mesma linguagem de query.
Escolhendo a configuração de compaction
O UCS é recomendado para tabelas novas, mas não é o padrão: o cassandra.yaml do trunk ainda cai na size-tiered. O segundo arquivo, cassandra_latest.yaml, liga o UCS em T4, junto com uma MemTable baseada em trie e o formato de SSTable BTI, indexado por trie, os dois adicionados na 5.0.
Depois, ajuste pela conta que dói:
| Se isto dói | Faça isto |
|---|---|
| Reescritas, ou compaction ficando para trás | Fique perto de T (T4 é o padrão) |
| Leituras, e o Bloom filter não ajuda (partições largas) | Vá na direção de L (L10) |
| Dados em ordem com TTL | T8, ou janelas de tempo |
E três jeitos de se queimar: janelas de tempo em linhas que são editadas ou apagadas, como mensagens de chat; um período de carência menor que a frequência real dos seus repairs; size-tiered num disco com mais da metade ocupada.
Fontes e leitura complementar
Fontes
- Bo Ingram, How Discord Stores Trillions of Messages, Discord, 2023.
- Stanislav Vishnevskiy, How Discord Stores Billions of Messages, Discord, 2017.
- Apache Cassandra, Size-tiered compaction (STCS).
- Apache Cassandra, Leveled compaction (LCS).
- Apache Cassandra, Unified compaction (UCS).
- Apache Cassandra, UnifiedCompactionStrategy.md, the design document.
- Apache Cassandra, Time-window compaction (TWCS).
- Apache Cassandra, Tombstones.
- Apache Cassandra, Repair e Hints.
- Apache Cassandra, Dynamo architecture.
- Apache Cassandra, NEWS.txt, CompactionTask.java, LeveledManifest.java, Config.java, trunk em b110470 (2026-09-28).
- Apache Cassandra, Cassandra 5.0 announcement, 2024, e CEP-26: Unified Compaction Strategy.
- Jonathan Ellis, Leveled Compaction in Apache Cassandra, DataStax, 2011 (arquivado).
- CASSANDRA-1608: Redesigned Compaction, CASSANDRA-6602 (DTCS), CASSANDRA-9666 (TWCS).
- Alex Dejanovski, TWCS part 1: how does it work and when should you use it?, The Last Pickle, 2016.
- Niv Dayan, Scaling Log Structured Key-Value Stores, Microsoft Research.
- Netflix Technology Blog, Introducing Netflix’s Key-Value Data Abstraction Layer, 2024 (arquivado).
- Apache Cassandra, project homepage (depoimento da Bloomberg) e Data modeling.
- Amazon Web Services, Amazon Keyspaces.
Leitura complementar
- Aleksey Yeschenko, Cassandra Anti-Patterns: Queues and Queue-like Datasets, DataStax, 2013 (arquivado).
- Branimir Lambov, The Unified Compaction Strategy in Cassandra 5, The ASF (o próprio autor explicando o design).
- Niv Dayan e Stratos Idreos, Dostoevsky: Better Space-Time Trade-Offs for LSM-Tree Based Key-Value Stores, SIGMOD 2018.
- Raphael S. Carvalho, Incremental Compaction 2.0, ScyllaDB, 2021.